❌

Reading view

Старый трейдер поделился секретом заработка. Я проверил с помощью кода. Удалось заработать?

Есть в трейдинге фраза, после которой мне хочется открыть не терминал, а Python:
«Эта стратегия работает десятилетиями»

Хорошо. Десятилетия прошли. А прибыль-то осталась?

Читать далее
  •  

Как построить self‑hosted RAG‑систему с LangGraph‑агентом на локальных LLM

Обычно стек для RAG‑систем и AI‑агентов строится вокруг облачных API (OpenAI, Anthropic) и управляемых векторных баз. Но для ряда задач критически важна полная автономность: устойчивость к санкциям и независимость от внешних провайдеров.

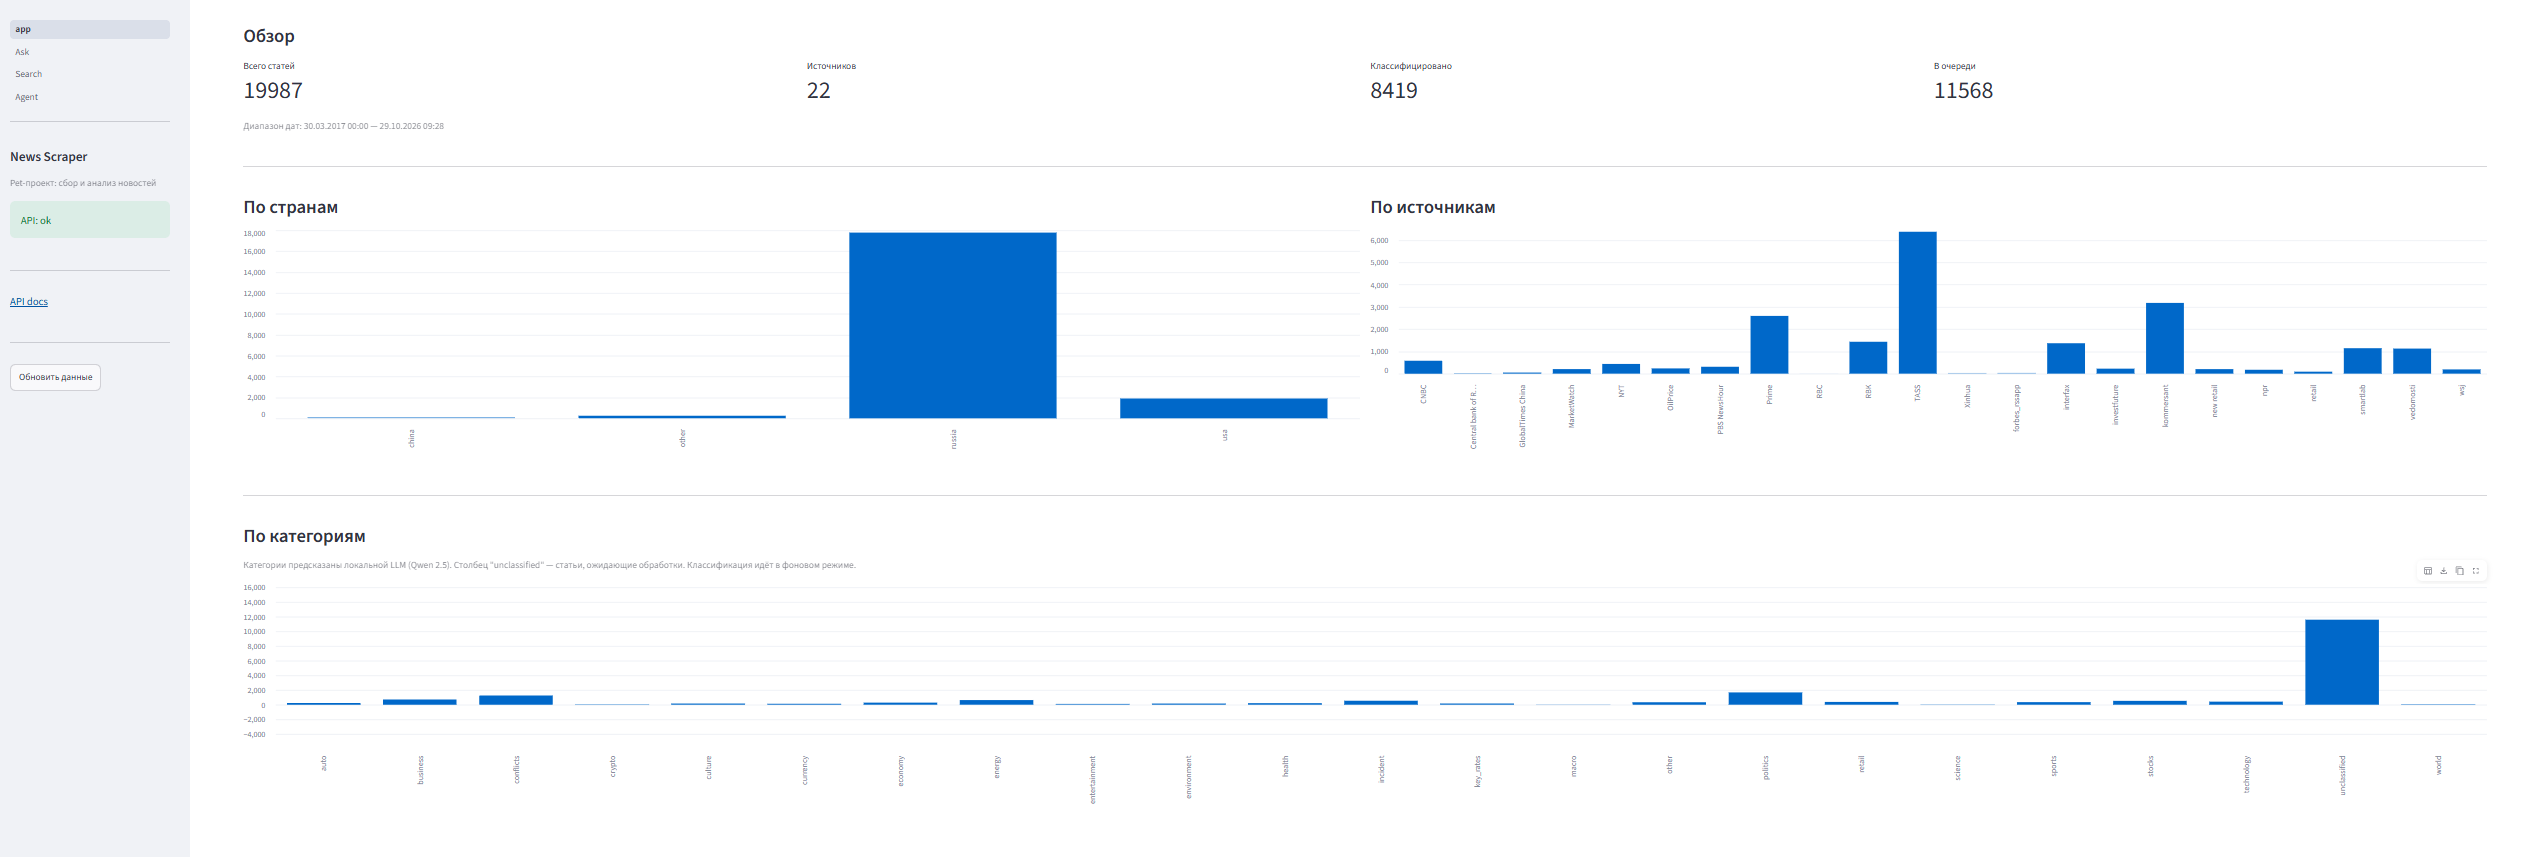
В этой статье я расскажу, как спроектировал и собрал аналитическую систему, которая за две недели работы агрегировала более 12 000 новостей: от сбора RSS‑лент до умного агента, который сам вызывает инструменты. Мы пройдем путь от архитектуры до граблей, на которые я наступил.

Стек: Python 3.12, FastAPI, PostgreSQL + pgvector, Celery, LangGraph, Ollama (Qwen 2.5 14B, BGE‑M3), Streamlit, Langfuse, Docker.

Читать далее
  •  

Остатки нельзя обороты

IT драма с элементами комедии

Фриланс манит свободой — к черту офис! Теперь ты сам себе начальник! Однако свобода эта обманчива. Вот вроде сидишь ты, работаешь дома, тебе тепло и сухо, и начальства над тобой нет, и никто не мешает, ты один... совсем один. И отвечаешь за все ты. А время уже далеко за полночь, А код выкидывает исключения, а Django ORM отказывается вывозить нагрузку, а все варианты архитектуры сулят скорее минусы, а таймер биржи неумолимо тикает. Тик‑тик‑тик... И нужно уже что‑то решать, но помочь некому — психов нет.

Читать далее
  •  

Когда Python становится слишком медленным: пишем C‑расширение с нуля и сравниваем с pybind11 (бонус JIT‑компилятор)

Недавно я прочел статью про pyrusmorph — python обёртку над 30-летним с++ ядром libmorph/rus. Бенчмарки удивили: в 30 раз быстрее PyMorphy3 при обработке текста. После я задумался. Как это вообще работает? Почему мы пишем import pyrusmorph и получаем доступ к нативному с++ коду и функциям прямо внутри python.

В статье я предлагаю пройти этот путь с нуля. Разобраться, как устроен Python «под капотом», написать своё расширение на чистом C‑API, а потом посмотреть, как эту боль лечит pybind11. В конце — бенчмарки и практические советы, когда вообще стоит лезть в c++ для оптимизации. Бонус — немного о компиляторе python кода (JIT‑компилятор)

Читать далее
  •  

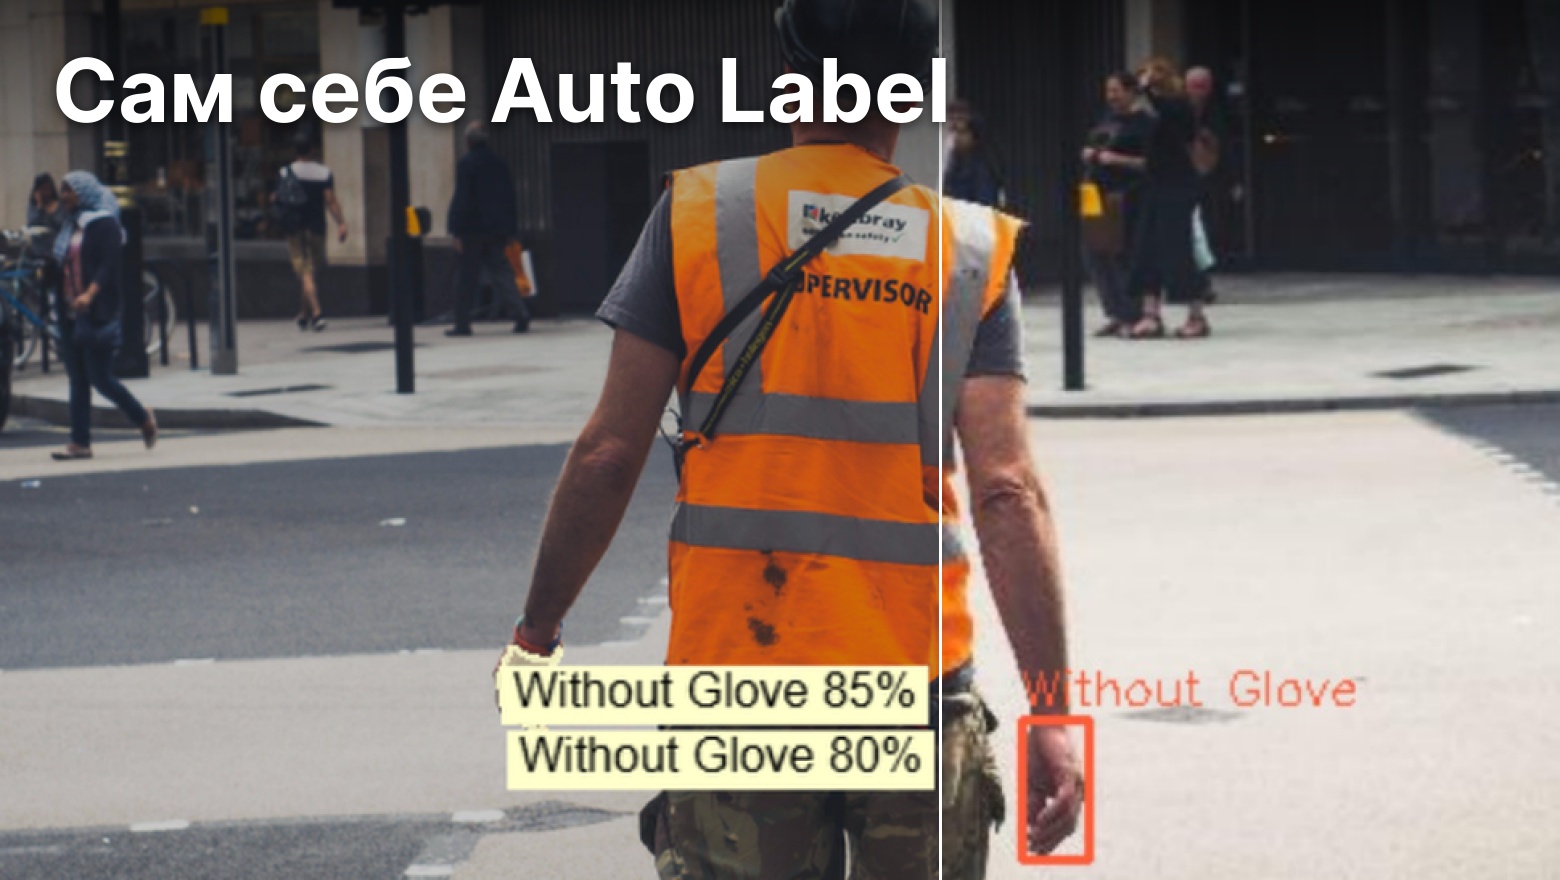
Бесплатный аналог Auto Label от Roboflow: как я разметил 12 576 кадров за ночь

Под диплом мне нужен был датасет по средствам индивидуальной защиты. Шесть классов, и хуже всех в открытых наборах представлена сварочная маска: после удаления дублей около двух тысяч кадров. Я нарезал видео, получил в пять-шесть раз больше кадров, чем попало в итог, и упёрся в разметку.

Auto Label у Roboflow задачу решал, но на бесплатном тарифе это полгода ожидания, а платный прогон по всему массиву обошёлся бы примерно в двести долларов. Поэтому я написал автоаннотатор на SAM3: пятнадцать файлов на PyQt6, текстовые промпты вместо обучения, пороги по классам.

Главный трюк — конфликты классов. SAM3 находит «руку» и «перчатку», а нарушение приходится вычислять вычитанием: если бокс руки перекрыт перчаткой больше чем на четверть, он уходит в нарушение. На этом держится вся разметка шести классов.

Итог: 12 576 кадров, 104 726 боксов, одна ночь на RTX 4060 Ti, ноль рублей. Модель на датасете даёт mAP50 = 0.825. В статье есть код и разбор того, где SAM3 врёт.

Читать далее
  •  

Агент повесил Bash одной кавычкой. Как детерминированный FSM спасает CLI-рантаймы

Представьте: ваш автономный агент генерирует команду для терминала, но ошибается на один символ. Шелл уходит в бесконечное ожидание, а процесс агента намертво зависает. Сегодня разберём, почему регулярки не спасают от этой боли, и покажем, как детерминированный конечный автомат (FSM) на хуке PreToolUse снимает проблему на уровне инфраструктуры.

Читать далее
  •  

Как я рисовал NFT-подарки Telegram в 60 fps, не имея API: бот для эмодзи, стикеров и подарков

В Telegram есть премиум-эмодзи, паки стикеров и NFT-подарки. Всё это красиво выглядит, но достать оттуда что-то для своей работы неудобно. Скачать пак целиком нельзя. Чтобы узнать custom_emoji_id, нужен отдельный бот или отладчик. А анимацию подарка вне Telegram можно разве что записать с экрана.

Я написал бота Emoji Studio, который всё это делает. В статье — не столько про сами функции, сколько про несколько интересных задач, которые пришлось решить по дороге:

Читать далее
  •  

[Перевод] Я встроил процессор RISC-V в веса Qwen 3.5, а памятью ему стали слои DeltaNet

Qwenputer — это обычная Qwen 3.5 4B, в веса которой скомпилирован 32-битный процессор RISC-V (RV32IM). Оперативной памятью ему служат собственные слои Gated DeltaNet модели: при гейте 1, силе записи 1 и one-hot-ключах каждая запись перезаписывает ровно одну строку состояния, а one-hot-запрос возвращает точное значение. Процессор занимает 11 слоёв перед 32 слоями Qwen, проходит официальные riscv-tests и выполняет C и MicroPython внутри прямых проходов модели, без внешних инструментов. На длинной арифметике NUPA точность выросла с 48,6% до 100%, примерно на 230 000 позиций вывода не нашлось ни одного расхождения с эталонной машиной. Автор объясняет, как это устроено, где ограничения и как к модели прикрутили файловую систему.

Читать далее
  •  

Дедупликация фото без нейросетей. Часть 1: измеряем перцептивные хеши

Недавно у нашей команды появилась необходимость отвечать на вопрос: А такое фото у нас уже есть?». Не «такой же файл» — его можно было бы легко проверить по SHA-256, — а именно такое же фото: пережатое, уменьшенное, с чужим логотипом поперёк кадра, подрезанное по краям.

Про перцептивные хеши на Хабре написано много, почти везде разбирают устройство алгоритма. Мне же хотелось понять, что он выдерживает. Поэтому я взял двадцать фотографий, изменил каждую двадцатью шестью способами из тех, что реально случаются при перезаливе, и посчитал расстояния.

Это первая часть из двух. Она про то, что хеши умеют и где ошибаются: водяные знаки, геометрия кадра, выбор метода, длина хеша, порог. Во второй части я расскажу, как из этого сделать работающую систему: предобработка, зеркало и поиск в PostgreSQL с бенчмарком на десяти миллионах строк.

Читать далее
  •  

Джойстик отпустили. Робот не в курсе

После ожидания SDK обработчик геймпада отправлял старую ось, хотя нейтраль уже лежала в очереди. Дочитывание ввода, отдельный исполнитель кнопок и deadline для RLock. Программные проверки и отдельный опыт с 8Bitdo SN30 Pro по Bluetooth.

Читать далее
  •  

Байты приходят, события нет: проверяем кадры SSE и gzip

Сервер отправляет по SSE три сообщения с паузой 250 мс, а клиент видит события только через 750 мс. Собрал стенд на стандартной библиотеке Python и поставил три отметки времени: байты тела ответа, текст после декодера gzip, готовое событие. Незавершённый кадр и сжатие без промежуточного сброса дают одинаковый симптом, но задержка появляется в разных точках.

Читать далее
  •  

Данные для языка, которого почти нет в интернете: текстовые слои, турецкие подмены и псевдоразметка двумя моделями

В первой статье серии я писал, что у крымскотатарского не было ни одного датасета, пригодного для серьёзной работы, и что начинал я с существующего речевого набора, который пришлось чистить. Во второй распознавалка научилась слышать нашу речь, в третьей синтезированный голос прочитал целый роман. Отсюда вопрос, который мне задавали чаще всего: если данных нет, на чём всё это училось?

Эта статья про данные. Оговорка та же, что и раньше, только строже: я не называю источники, архивы, издания, каналы, людей и организации, которые нам что-то передали, и не рассказываю о договорённостях с ними. Нет здесь и названий моделей, порогов фильтров и внутренних скриптов. Объёмы даю порядками величин. Зато будут метрики, методика проверки и грабли, на которые я наступил, и все цифры взяты из отчётов экспериментов, а не по памяти.

Читать далее
  •  

Как генератор трёх слов на баннере вырос в веб-сервис: Ghostscript, CMYK и производственные грабли

На фрилансе регулярно просят сверстать простой баннер «АРЕНДА + телефон». Брать за три слова 2 000 рублей неловко, а запускать CorelDRAW, выставлять миллиметры и переводить шрифты в кривые всё равно приходится. Рассказываю, как внутренний скрипт для генерации валидного CMYK PDF вырос в производственный сервис с динамическим разрешением Ghostscript, инспектором структуры PDF, пакетной сборкой из CSV и партнёрским режимом для типографий.

Читать далее
  •  

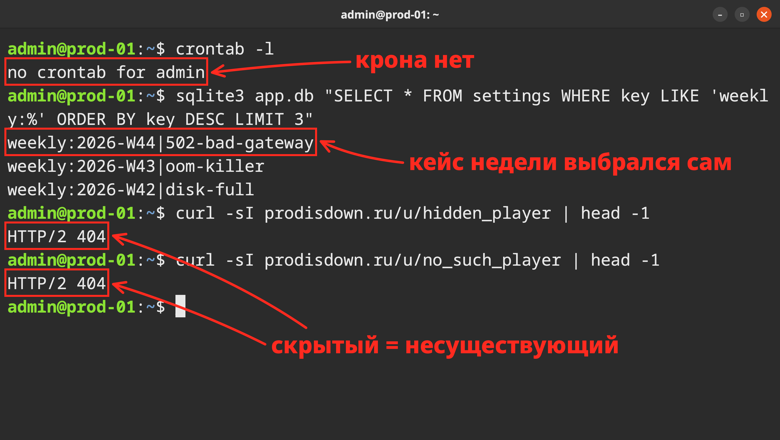
Дежурство недели: еженедельный рейтинг на Flask и SQLite без крона

В прошлых статьях я рассказывал, как устроен мой тренажёр инцидентов, и разбирал кейс с 502 Bad Gateway. Сегодня утром я релизнул два новых режима: «дежурство недели» и публичный профиль игрока. Покажу, как они устроены: там нет ни крона, ни новых таблиц, и всё равно есть пара мест, где легко ошибиться.

Читать далее
  •  

7 паттернов микросервисной архитектуры на примере музыкального сервис

Представим, что мы разрабатываем сервис для прослушивания музыки — Пай.Музыку. В него уже заходит больше 100 тысяч пользователей в месяц, в команде работает 10+ инженеров, а недавно к музыке добавились подкасты и личный кабинет музыканта. Новые направления хочется часто обновлять и отдельно масштабировать (из-за разной нагрузки), основную логику — релизить пореже. Но пока всё живёт в одном монолите: общий релизный цикл тормозит команды, а изменения в одних и тех же файлах приводят к мерж-конфликтам.

Команда приняла решение распилить монолит на несколько микросервисов. Но вот незадача: почти никто не имел такого опыта, а о паттернах читали лишь в книжках. Давайте поможем команде внедрить нужные паттерны, заодно обсудив, какую проблему они решают и чем приходится платить за это.

На примере этой системы разберём семь паттернов микросервисной архитектуры, их ограничения и короткие примеры на Python.

В этой статье слова “сервис” и “микросервис” используются взаимозаменяемо.

Читать далее
  •  

«Лучше пять раз переспросить, чем один раз выдумать» — я посадил ИИ-ассистента отвечать коллегам в рабочем мессенджере

Всем привет! Меня зовут Александр, я руковожу направлением аналитики страховой вертикали в Банки.ру. Наша вертикаль живёт в отчётах и данных: продажи ОСАГО и КАСКО, ипотечное страхование, кроссы, пролонгация, воронки, кэшбэк и сверки с партнёрами.

И каждый день в рабочем мессенджере на меня прилетает поток одного и того же жанра: «где посмотреть КВ по ОСАГО за сентябрь?», «почему упало одобрение у страховой?», «сделай выгрузку по регионам», «это у нас баг или так и задумано?». КВ здесь комиссионное вознаграждение.

Постепенно аналитик превращается в справочное бюро. Ответы есть, но живут они в голове, в SQL-запросах и в вики, а вопросы приходят в личку и в каналы в любой момент, в том числе пока ты на встрече. Я решил посадить на эту очередь ИИ-ассистента. Условие одно и жёсткое: ассистент не выдумывает. В аналитике выдуманная цифра хуже отсутствия ответа, потому что по ней примут решение.

В статье рассказал, как бот устроен, какие правила не дают ему врать и как он им учится.

Читать далее

  •  

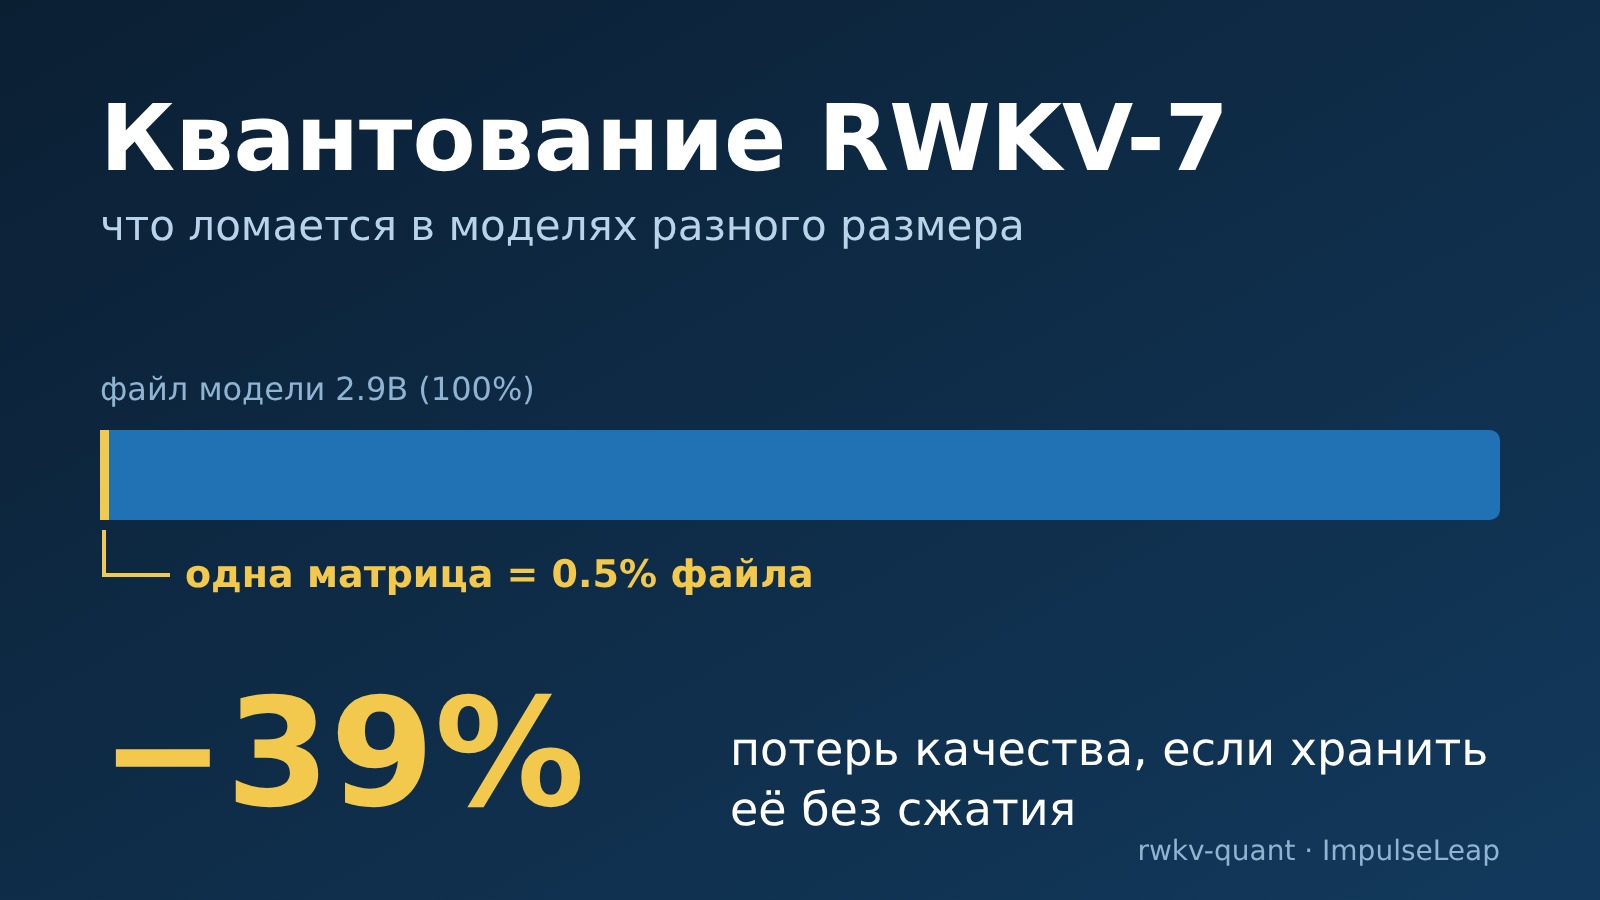
Квантование RWKV-7: что ломается в моделях разного размера

Я изучаю посттренировочное квантование семейства RWKV-7 (от 0.1B до 13.3B параметров) двумя пресетами: REDUCTION (сжатие около 2.1x, почти без потерь) и COMPRESSION (около 3.1x, 4 бита на проекции). Исходный вопрос работы: почему 4-битный пресет на модели 2.9B деградирует сильнее, чем на 1.5B (+4.04% против +2.85% по перплексии), хотя ожидается обратное.

Оказалось, что до 86% вклада всей группы o_proj на 2.9B приходится на одну матрицу: выходную проекцию нулевого блока. Её вход несёт «массивный канал» (98% энергии входа в восьми каналах из 2560). Хранение этой одной матрицы в bf16 (0.5% файла) снижает KL к эталону на 39% и возвращает 2.9B в монотонную линейку; перевод эмбеддинга с 5 на 6 бит добавляет ещё −22% KL за 1.1% файла. Три естественные локальные метрики ошибки не предсказывают вред от квантования матрицы; предсказывает ошибка, внесённая в остаточный поток и умноженная на усиление ниже по глубине. На этом основании я строю автоподбор битности по правилу «снятый вред на байт» (−16…−39% KL при приросте файла не более 0.5%) и переношу GPTQ на ту же сетку (−29…−43% KL при тех же байтах).

Вместе методы дают потерю по перплексии от +2.76% (0.1B) до +0.70% (13.3B) на файле размером 31.6–35.2% от bf16, монотонно убывающую с размером модели. Пресет REDUCTION с GPTQ даёт +0.46…+0.07% при 46–50% от bf16. При равном размере файла KL моего 6-битного файла с GPTQ в 2.0–3.3 раза ниже, чем у GGUF Q6_K с imatrix, и в 3.5–7.4 раза ниже, чем у MLX int6; 4-битный файл в 2.1 раза точнее Q4_K_M на 1.5B, а Q4_K_M на 2.9B ломается. Отдельно описываю утечку калибровочного корпуса в мой первый оценочный набор и измеренный масштаб её влияния, а также разброс GPTQ между численно эквивалентными реализациями (около ±1.5% KL).

Читать далее
  •  

[Перевод] Эмулятор Game Boy Color на MicroPython: Pokémon Crystal на конференц-бейдже с RP2350

Стив Франсиа, автор Hugo и Cobra, после эмулятора NES запустил на конференц-бейдже GitHub Universe с RP2350 эмулятор Game Boy Color — на MicroPython с генератором кода Viper. Процессор SM83 с его восемью регистрами и 512 опкодами не влез в четыре быстрые локальные переменные Viper, и декодер пришлось строить на восьмеричной раскладке опкода. Ветвления по адресу заменила таблица из 16 страниц по 4 КБ, двухмегабайтные картриджи подгружаются по банку при первом обращении, а разгон до 300 МГц вешал общую шину QSPI. Плюс три бага из реальных игр: окно диалога в Oracle of Ages, «вывернутый» Линк в режиме двойной скорости и указатель стека, который Pokémon Crystal направляет прямо в ROM.

Читать далее
  •  

Почему softmax теряет градиенты — и как школьная алгебра 7-го класса помогает их сохранить

Модель почти идеально выучила ответ, а градиент правильного класса уже стал машинным нулём. При дистилляции возможна обратная ситуация: ученик повторяет учителя, но вычисление всё ещё выдаёт сигнал ошибки. Разбираю исправления DeepMind на школьной алгебре, проверенных примерах NumPy и четырёх графиках: где теряются маленькие числа, как это влияет на обучение и что стоит проверить в своей среде.

В статье есть практические рекомендации, как понять, нужно ли это учесть в ваших программах и нейросетях, и если нужно — как исправить в своем коде ошибку из стандартных библиотек.

Самое удивительное тут то, что, казалось бы, подобная тема должна быть исследована вдоль и поперек еще на заре развития машинного обучения, а в реальности важнейший научный препринт от DeepMind об этом вышел 22 октября, то есть меньше недели назад.

Кроме того, рекомендую включать этот материал в базовые учебные курсы.

Читать далее
  •  

AI-менеджер для WB, Ozon и Маркета: отдали решения агенту и сразу его ограничили

Первую версию AI-менеджера маркетплейсов мы собрали на регулярках: фраза → операция из закрытого списка → API площадки. Первые владельцы быстро показали, где это ломается: люди пишут не по списку, а цифры без выводов селлеру не нужны.

Мы переделали менеджера в агента: модель сама выбирает инструменты и порядок. И сразу же его ограничили: 8 шагов и 150 секунд на ход, узкие инструменты, запись в кабинет — только после «да» владельца. Рассказываем, как это устроено, с кодом, и что дали агенту вместо сценариев.

Читать далее
  •  
❌