❌

Reading view

Пайпы OpenWebUI: зачем писать код там, где «всё уже есть в настройках»

Настроить кастомную модель с инструментами и RAG в OpenWebUI — легко. Заставить её работать предсказуемо в бою — сложнее. Наш бот техподдержки на Gemma 4 сначала отвечал правдоподобно, но без данных из систем. Мы разобрались, почему это происходит, и превратили «одну модель в интерфейсе» в детерминированный конвейер с помощью пайпов.

Читать далее
  •  

Как построить self‑hosted RAG‑систему с LangGraph‑агентом на локальных LLM

Обычно стек для RAG‑систем и AI‑агентов строится вокруг облачных API (OpenAI, Anthropic) и управляемых векторных баз. Но для ряда задач критически важна полная автономность: устойчивость к санкциям и независимость от внешних провайдеров.

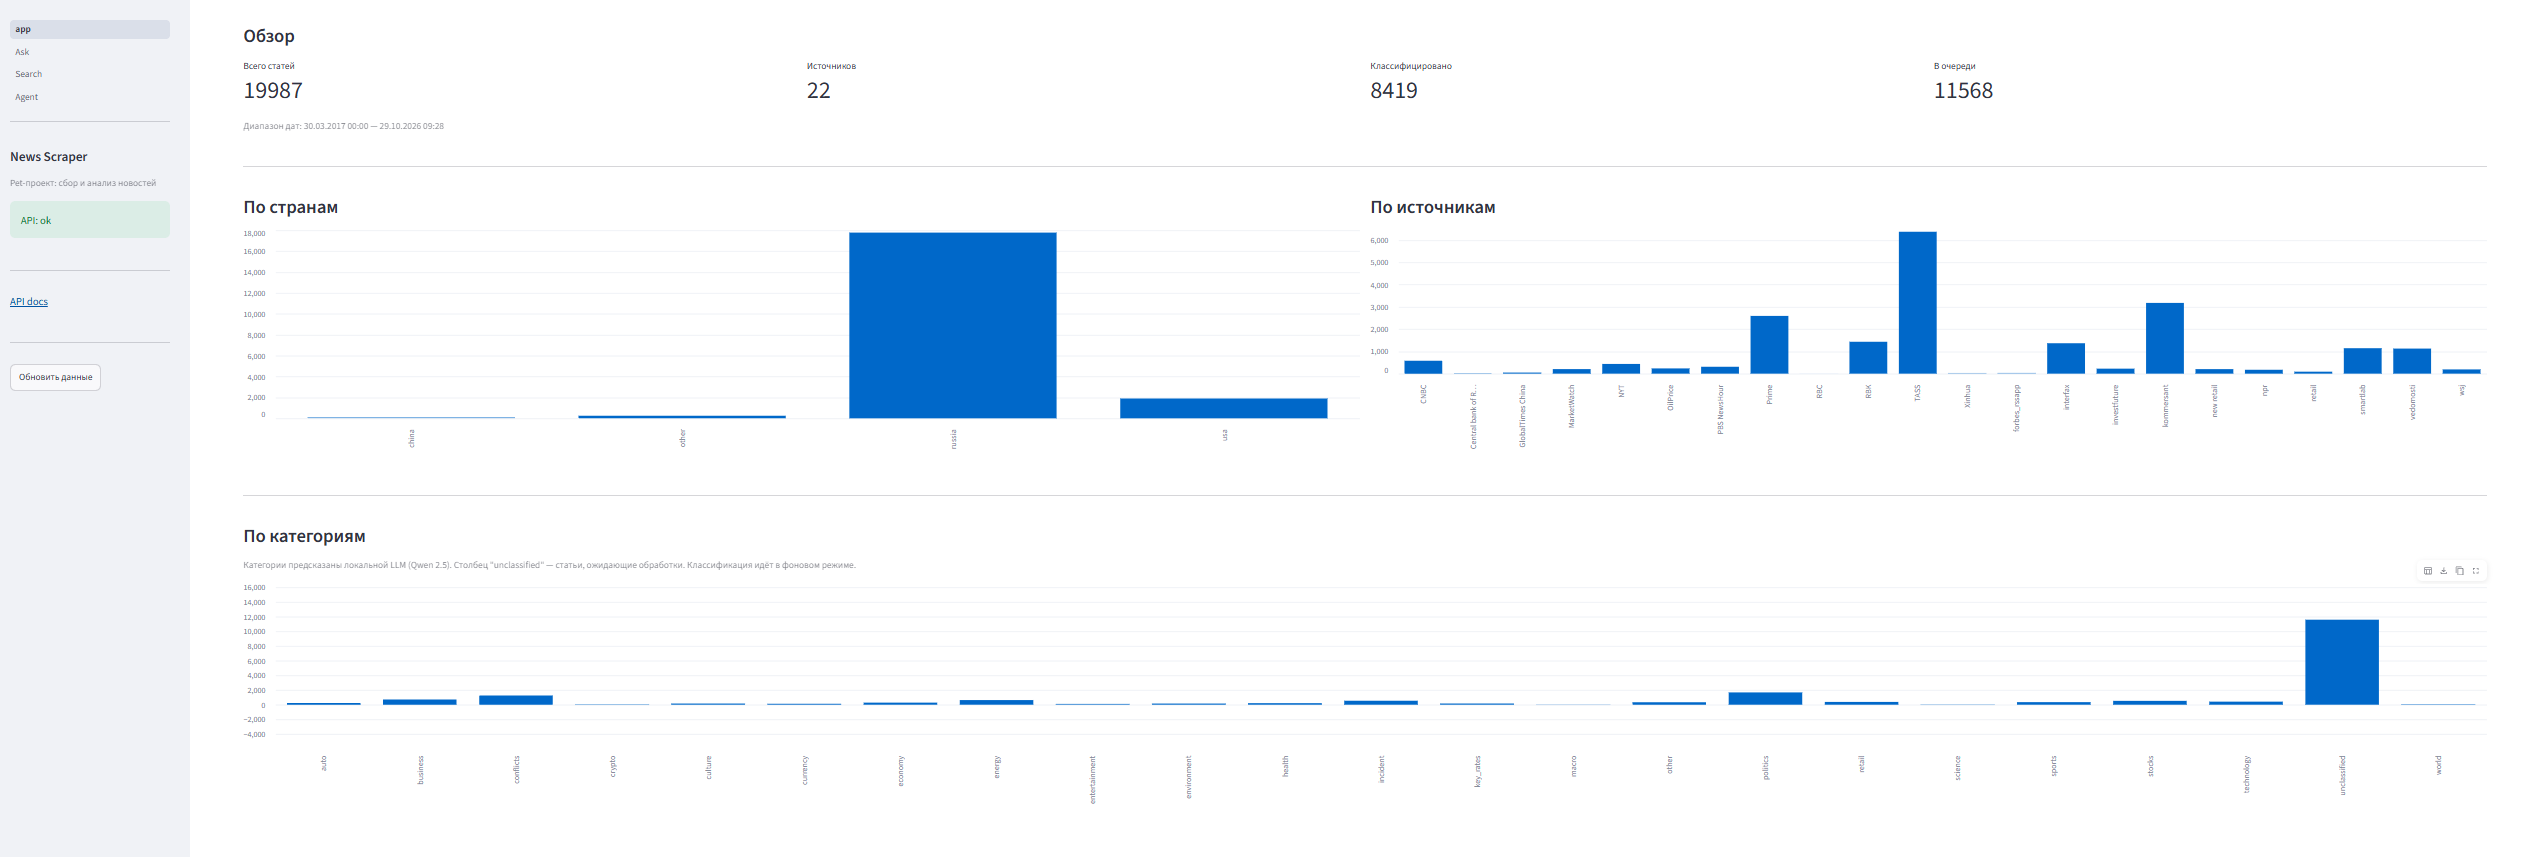
В этой статье я расскажу, как спроектировал и собрал аналитическую систему, которая за две недели работы агрегировала более 12 000 новостей: от сбора RSS‑лент до умного агента, который сам вызывает инструменты. Мы пройдем путь от архитектуры до граблей, на которые я наступил.

Стек: Python 3.12, FastAPI, PostgreSQL + pgvector, Celery, LangGraph, Ollama (Qwen 2.5 14B, BGE‑M3), Streamlit, Langfuse, Docker.

Читать далее
  •  

Что бэкапить в ИИ-приложении: модель, документы, индексы или историю диалогов?

Привет, Хабр! На связи Михаил Витко, менеджер PaaS-продуктов Рег.облака. Представим ситуацию. После восстановления ИИ-помощник принимает запросы и отвечает без ошибок. Но на вопрос о сроке возврата товара называет 14 дней вместо 30: база уже знает о новой редакции регламента, а поиск работает по старому индексу. Проверка доступности сервиса такую поломку не обнаружит.

В статье подробно разберем, как резервировать RAG-помощника по корпоративным документам и восстанавливать его части в согласованном состоянии. Тема обширная, поэтому мы разделили материал на две части. В первой поговорим о том, какие данные нужно сохранять, что можно пересоздать после сбоя и как организовать резервное копирование в S3, PostgreSQL и Kubernetes. А во второй обсудим, как восстановить приложение без рассогласования данных и проверить, что оно корректно работает после сбоя. 

Читать далее
  •  

Когда LLM должна сказать «Я не знаю»?

В RAG недостаточно найти документы на нужную тему: они должны содержать сведения, из которых можно обосновать ответ. Разберём три способа исследовать эту границу — от внешнего оценщика контекста до анализа активаций модели и испытаний на противоречивых свидетельствах.

Читать далее
  •  

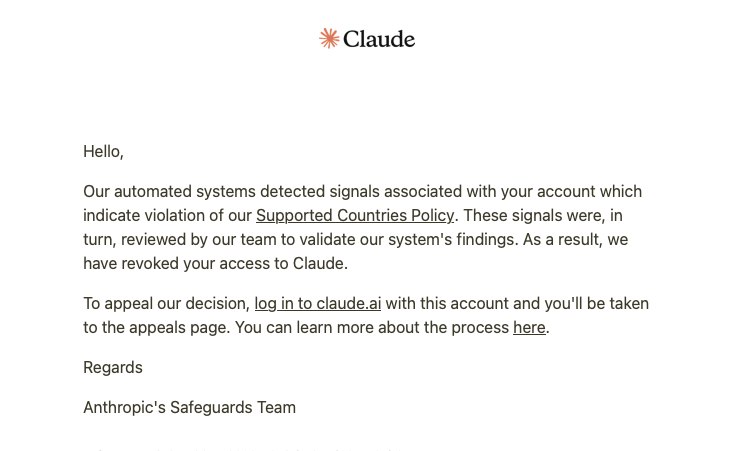
Anthropic заблокировала меня и я потерял подписку за $100, но сохранил год работы и собрал личную RAG-базу

Привет, Хабр!

Кто нибудь уже получал такие письма счастья? Причина - страна, оно и понятно, я вообще почитал что они начали массово банить за подключение через VPN и даже не разбираются что стоит за этим туннелем. Китай много так же банят. Я активно пользовался (около 5 часов в сутки) больше года активно и тут еще сгорела подписка за 100$.

Деньги - это неприятно, конечно... Но для меня более важно: проекты, переписки, решения, объяснения, почему мы выбрали именно такой вариант, где уже обкакались. Конкретный объем контекста меня в широком смысле: и работы, и личных вопросов.

Читать далее
  •  

Как сделать RAG по профессиональной документации

Привет, Хабр! Хотелось бы начать статью с такого вопроса: кто из нас еще не использовал чат ассистентов в своей работе и повседневной жизни? Вот и мы, команда Джеймикс, постоянно используем ИИ-агентов и ассистентов в своей рутине. Кто с нами не знаком — мы (Джеймикс, Jmix) open-source  платформа с ИИ-инструментами для стандартизации разработки корпоративных приложений на Java. И так уж вышло, что у нас есть потребность в постоянной поддержке нашего сообщества в эксплуатации и разработке на нашей же технологии. На это мы постоянно выделяли одного разработчика-дежурного, который отвечал на все вопросы наших клиентов. Понимаете куда ведет это повествование? Конечно же, как только появились языковые модели, которые научились сносно отвечать на технические темы — сразу же возникла идея о делегировании самых базовых и простых вопросов ИИ. Ну и, конечно же, мы на поезде хайпа еще в конце 2023-го года создали собственного ИИ-ассистента на базе ChatGPT 4, который отвечал на темы, связанные только с платформой Джеймикса.

Время шло, мы вводили небольшие продуктовые изменения и наш ассистент стал что-то вроде системы индексатора и поисковика для мозга-нейросети. Нас устраивала точность ответов нашего ассистента — но был нюанс. Индексатор-поисковик был нужен еще для внешних агентов, которые вызывали его через отдельный MCP — и тут было больше подводных камней.

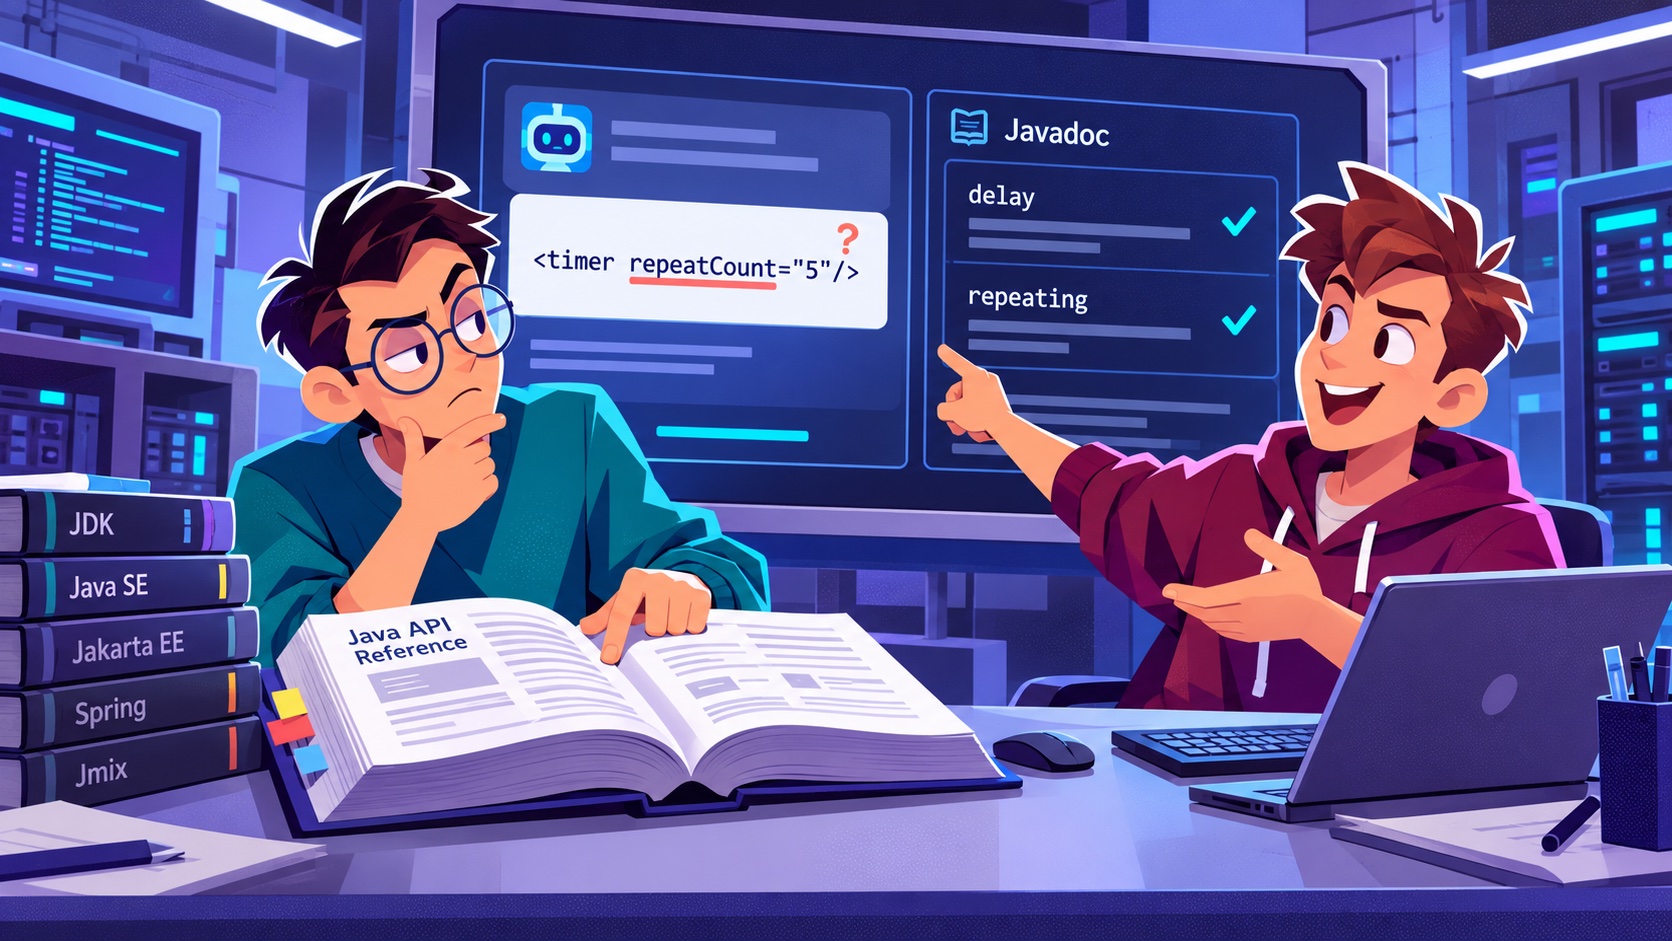
И вот прошло 3 года, и мы решили задать вопрос с подвохом (ну бывает же такое, когда хочется спросить что-то каверзное у ИИ). Звучал вопрос так: “какое значение repeatCount заставит таймер сработать пять раз”. Ассистент уверенно выдал готовый XML, хотя такого атрибута в Jmix нет. Чтобы ИИ-ассистент отвечал точнее, мы перестроили поиск. 

Читать далее

  •  

На каком языке ИИ-агенту искать по своей памяти: SQL или SPARQL?

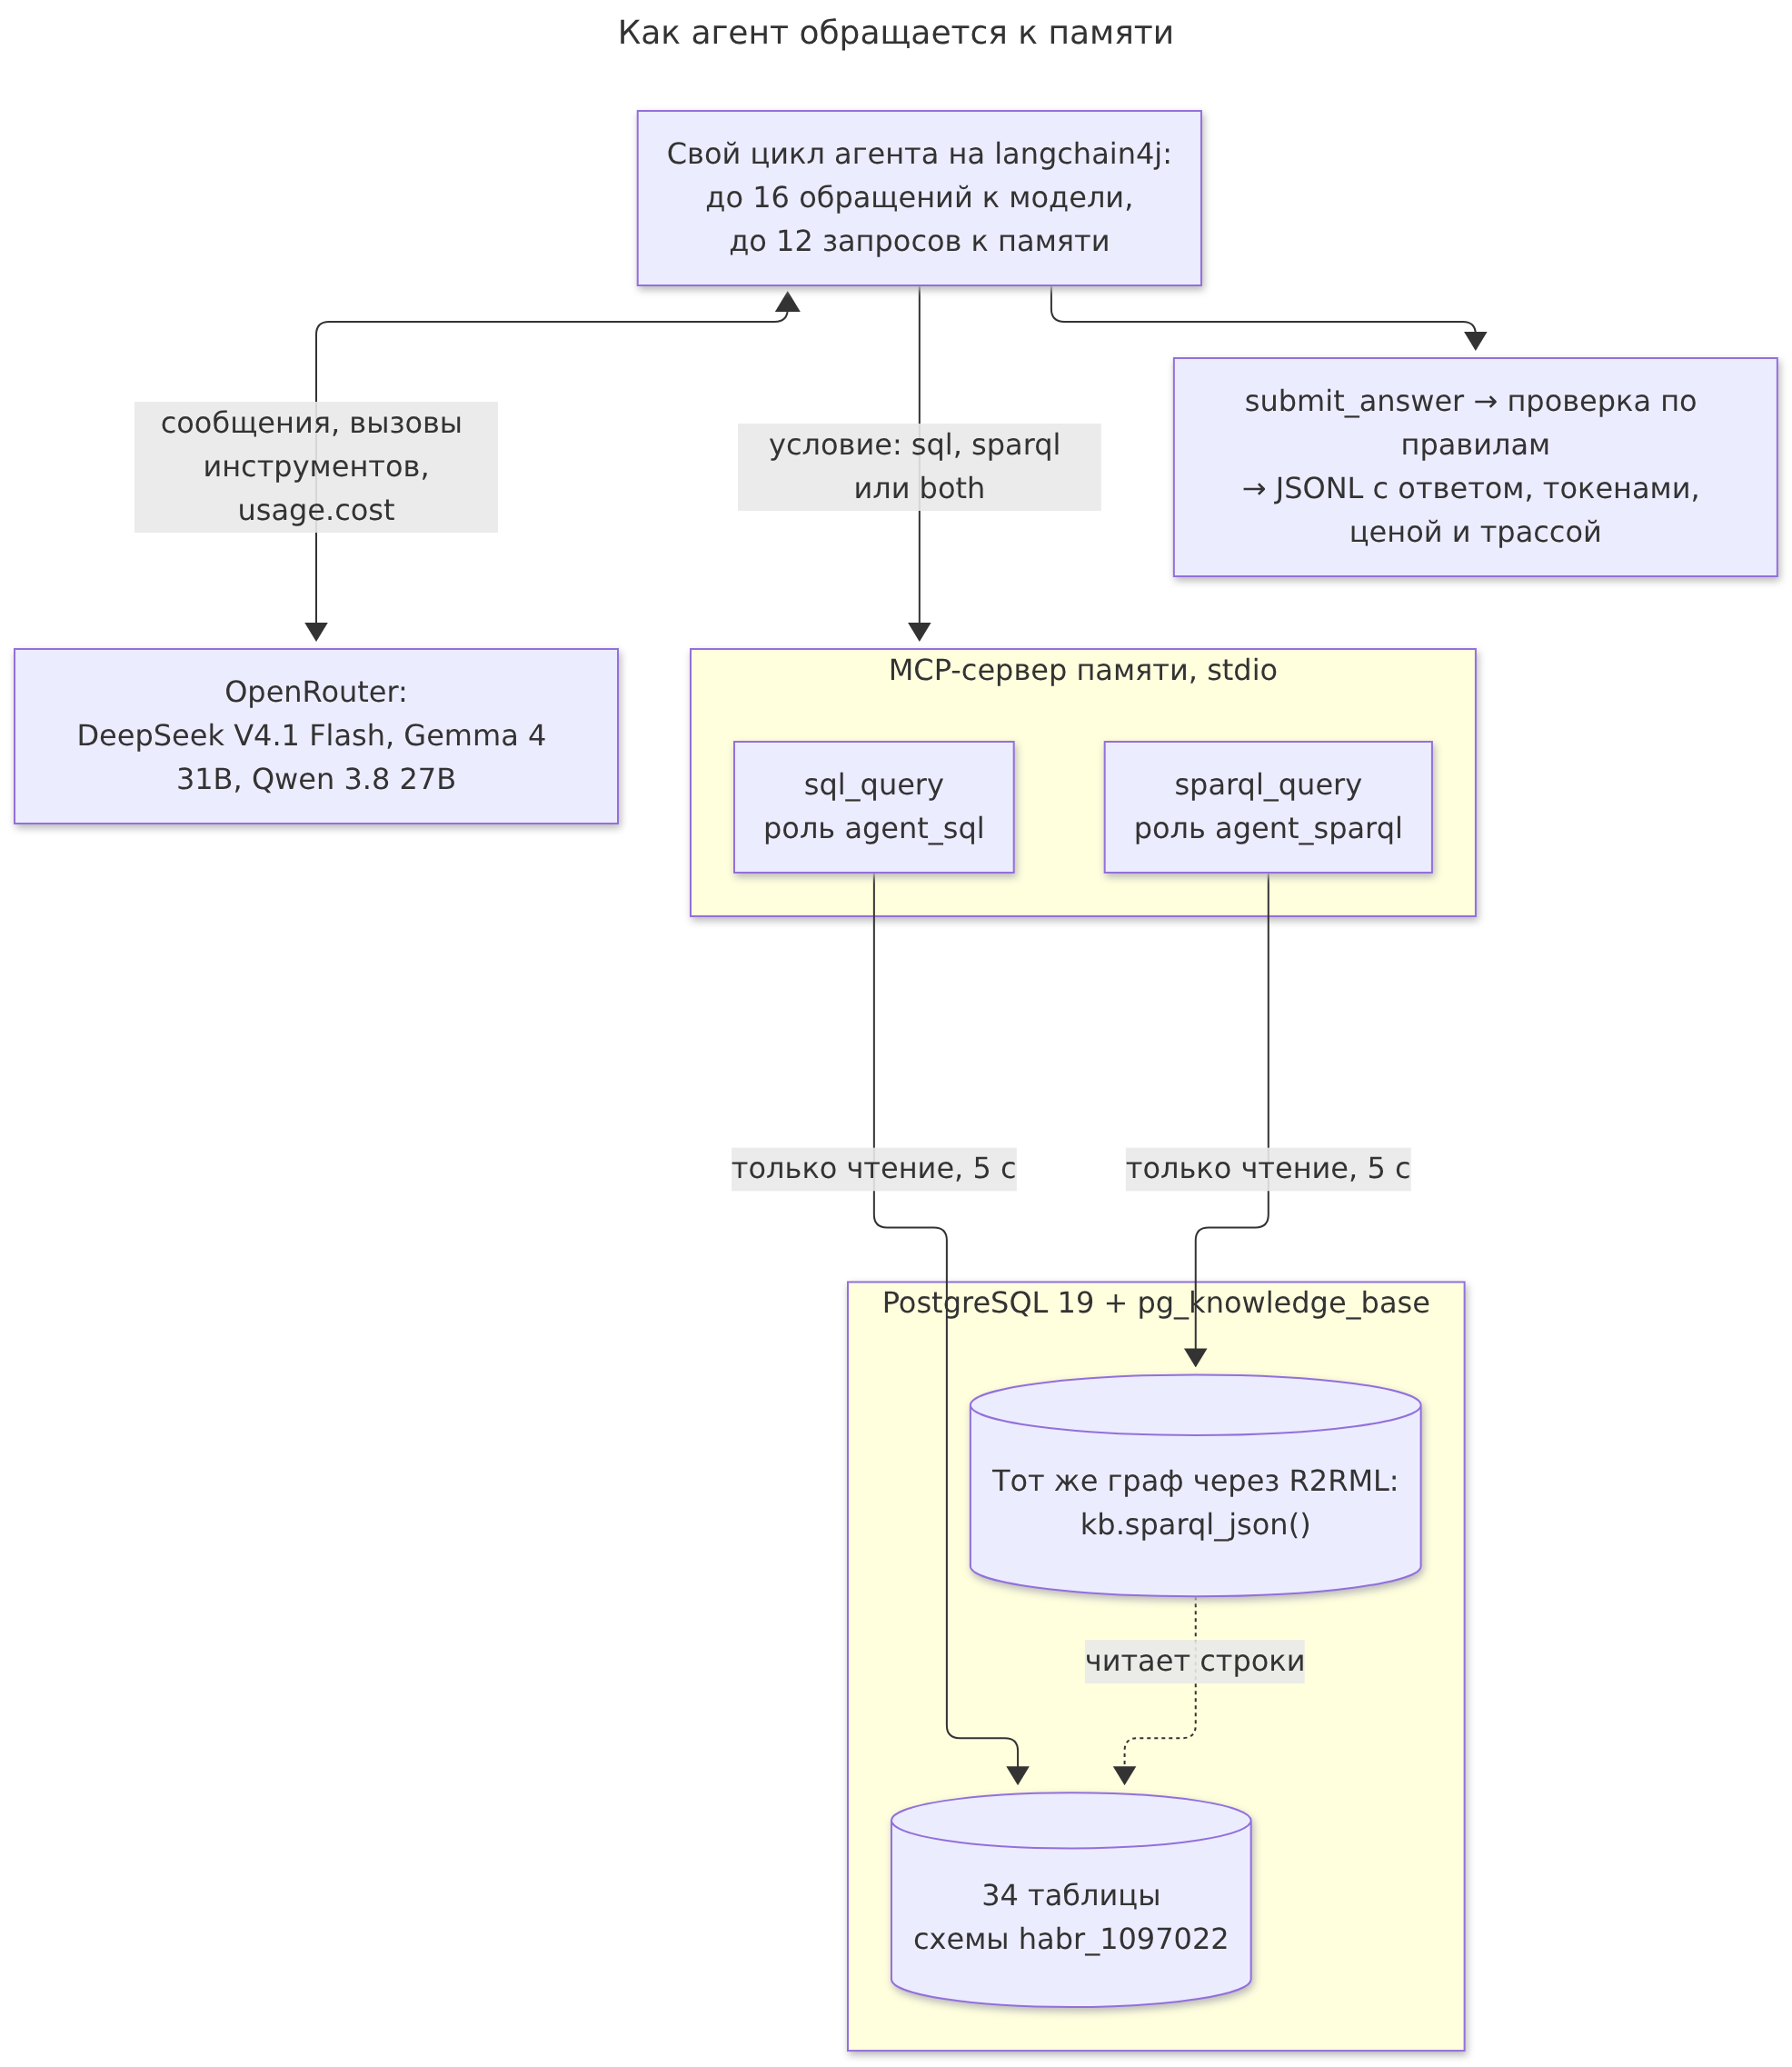
Память агентов в тренде с того момента как они появились, чтобы бороться с галюцинациями и давать ответы и решения LLM на собственной информации. Как лучше запрашивать информацию из таблиц или из графа часто решается на вере, начитавшись постов в интернет без своих экспериментов и измерений. В исследовании Sequeda и соавторов GPT-4 отвечал на вопросы по корпоративной SQL базе верно в 16% случаев, а по графу знаний поверх этой же базы в 54%, где у графа была онтология с описанием, а у SQL схемы только DDL типы и названия таблиц/колонок.

В моем GraphRAG одна и та же информация представлена в двух разных формах. Данные из статьи “Мой PostgreSQL быстрее твоего и почти догнал ClickHouse” извлек в 34 таблицы PostgreSQL, а в граф это превратил с помощью отображения R2RML. Подключил обе формы представления знаний к агенту по MCP и задал ему 15 вопросов о статье: через SQL, через SPARQL и дал еще выбор агенту из двух этих видов сразу. В моем эксперименте агент по очереди запускался на трех LLM с открытыми весами. Их можно развернуть на своей инфраструктуре или ноутбуке и данные и вопросы не уйдут провайдеру в логи или агрегатору между вами и LLM.

Таже я проверил и рассчитал что лучше для векторного хранения и семантического поиска: lance или pgvector. Поделюсь своими измерениями на современных моделях как лучше искать и в чем хранить знания.

Обнаружил в эксперименте как DeepSeek придумал SQL-инъекцию чтобы ответить на мой вопрос.

Читать далее
  •  
❌