❌

Reading view

Домашний прод, часть 1: от двух LXC до Istio
Я DevOps-инженер. В DevOps я перешел незадолго до начала этой истории, а до того год работал в сопровождении с элементами SRE. Еще раньше я сидел в центре мониторинга сетей у телеком-оператора. Дома у меня мини-ПК и медиасервер, которым каждый вечер пользуется семья. На этом медиасервере я и учился тому, за чем пришел в профессию: Kubernetes, Istio, Jenkins.

Медиасервер у меня собран из целого arr-стека. Так называют набор self-hosted сервисов, которые сами находят, качают и раскладывают по папкам фильмы и сериалы. Смотрим мы все в Jellyfin, это медиасервер, что-то вроде домашнего КиноПоиска. Заявки принимает Seerr (раньше он назывался Jellyseerr): выбрал фильм на витрине, и заявка ушла дальше. Фильмами занимается Radarr, сериалами Sonarr. Оба спрашивают Prowlarr, а тот ищет раздачи по торрент-трекерам. Если трекер закрыт капчей Cloudflare, Prowlarr проходит ее через FlareSolverr. Качает qBittorrent, субтитры подбирает Bazarr. Когда все работает, человек нажимает одну кнопку, и через какое-то время фильм появляется в Jellyfin.

В прошлой статье, «Я даже не пойму, если что-то сломал», я рассказывал, как бросил учебный демо-магазин и перенес все на медиасервер. Закончил я ее тем, что фильм играет, а значит, о поломке я узнаю. С дивана, как потом выяснилось, видно далеко не все. Самые неприятные ошибки за следующие месяцы выглядели как успех: джоба писала, что все прошло, кино играло, а того, что должно было случиться, не случалось.

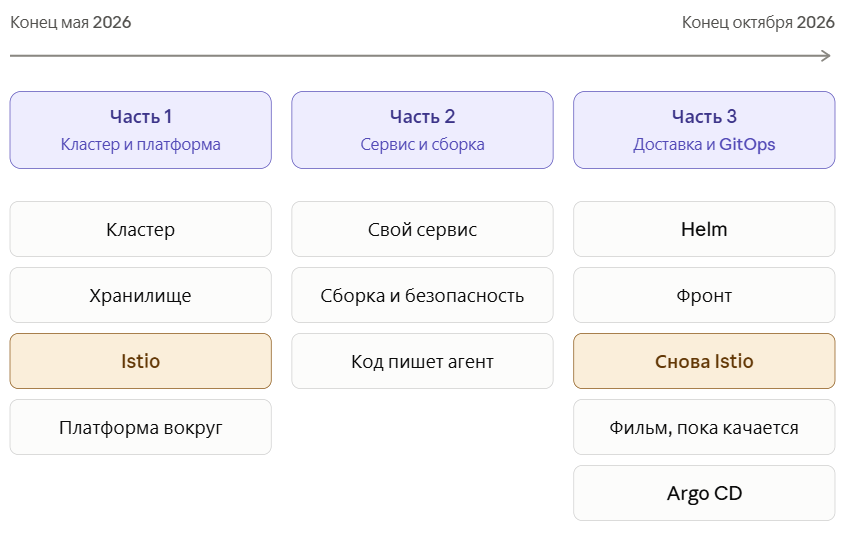
Пишу я это прежде всего для себя. С конца мая по конец октября 2026 года я сделал много отдельных кусков и ни разу не видел путь целиком. Хочу собрать его в одном месте и понять, что вообще произошло. Текста вышло на три статьи. Эта первая, про кластер, хранилище, Istio и платформу вокруг. Во второй будет свой сервис, сборка с проверками безопасности и то, как код у меня начал писать агент. В третьей Helm, фронт, возвращение к Istio, просмотр фильма, пока он качается, и Argo CD.

Читать далее
  •  

Если бы облачные сервисы были оружием, то MongoDB — граната без чеки

У нас под постом про ЦОДы развернулась дискуссия: какой должна быть ракета, чтобы устроить дата-центру пробитие. Я почувствовал себя среди оружейных баронов и экспертов по уничтожению дата-центров.

Знаете, у нас есть некоторая экспертиза в этом. Потому что сгоревших ЦОДов мало, а вот попадавших из-за кривых рук — очень много. Поэтому мы тут решили на Хэллоуин сравнить разные технологии с тем, как бы выглядело оружие на их базе.

Кроме MongoDB без чеки из заголовка у нас есть ещё 20 не менее убойных штук.

Читать далее
  •  

Управляемый DTLS-прокси на Rust: решения, ошибки и цена упрощения

В первой части я рассказывал, как, почти не зная Rust, взялся за UDP/DTLS-прокси для системы управления 300 тыс. устройств и поручил большую часть реализации ИИ. Тогда я сосредоточился на том, как меняется работа инженера, когда код пишет модель.

Теперь — техническая сторона этой истории: почему локальная таблица маршрутов в XDP теряла рукопожатия, как прокси без общего хранилища находит владельца DTLS-сессии и почему 26-байтовый CID с HMAC и подписанный PPv2 уступили более простым решениям. Расскажу, какие компромиссы пришлось принять и какие ошибки удалось обнаружить на испытаниях.

Читать далее
  •  

Объединяй и властвуй: как перенести ML-эксперимент из лабораторного кластера в промышленный за 60 секунд

Всем привет! Мы команда ML-платформы Ozon. Мы строим инфраструктуру, которой ежедневно пользуются дата-сайентисты и ML-инженеры — от первых экспериментов в Jupyter до обучения моделей на больших GPU-кластерах. Наша задача заключается в предоставлении доступа к современным вычислительным технологиям через привычные инструменты и единый интерфейс платформы. 

Со стороны может показаться, что формула счастья наших пользователей предельно проста: «GPU для всех, даром, и пусть никто не уйдёт обиженным». В реальности всё, конечно же, сложнее. Вычислительные ресурсы должны использоваться эффективно. При этом разные этапы рабочего процесса требуют разного оборудования и инструментов. Поэтому выполнять весь процесс на одном, пусть и сверхмощном, кластере не всегда рационально. Если же распределить этапы между несколькими кластерами, нужно обеспечить их взаимодействие, чтобы рабочий процесс выполнялся бесшовно.

Значит, нам необходим механизм, обеспечивающий эту связь. Решение, позволяющее взять пользовательский эксперимент, собрать его код и зависимости в одном кластере и воспроизвести в другом, — чтоб переход между стадиями рабочего процесса происходил в одно действие, быстро и удобно для пользователя. Как мы решили эту задачу и какие выводы сделали — в этой статье.

Читать далее
  •  

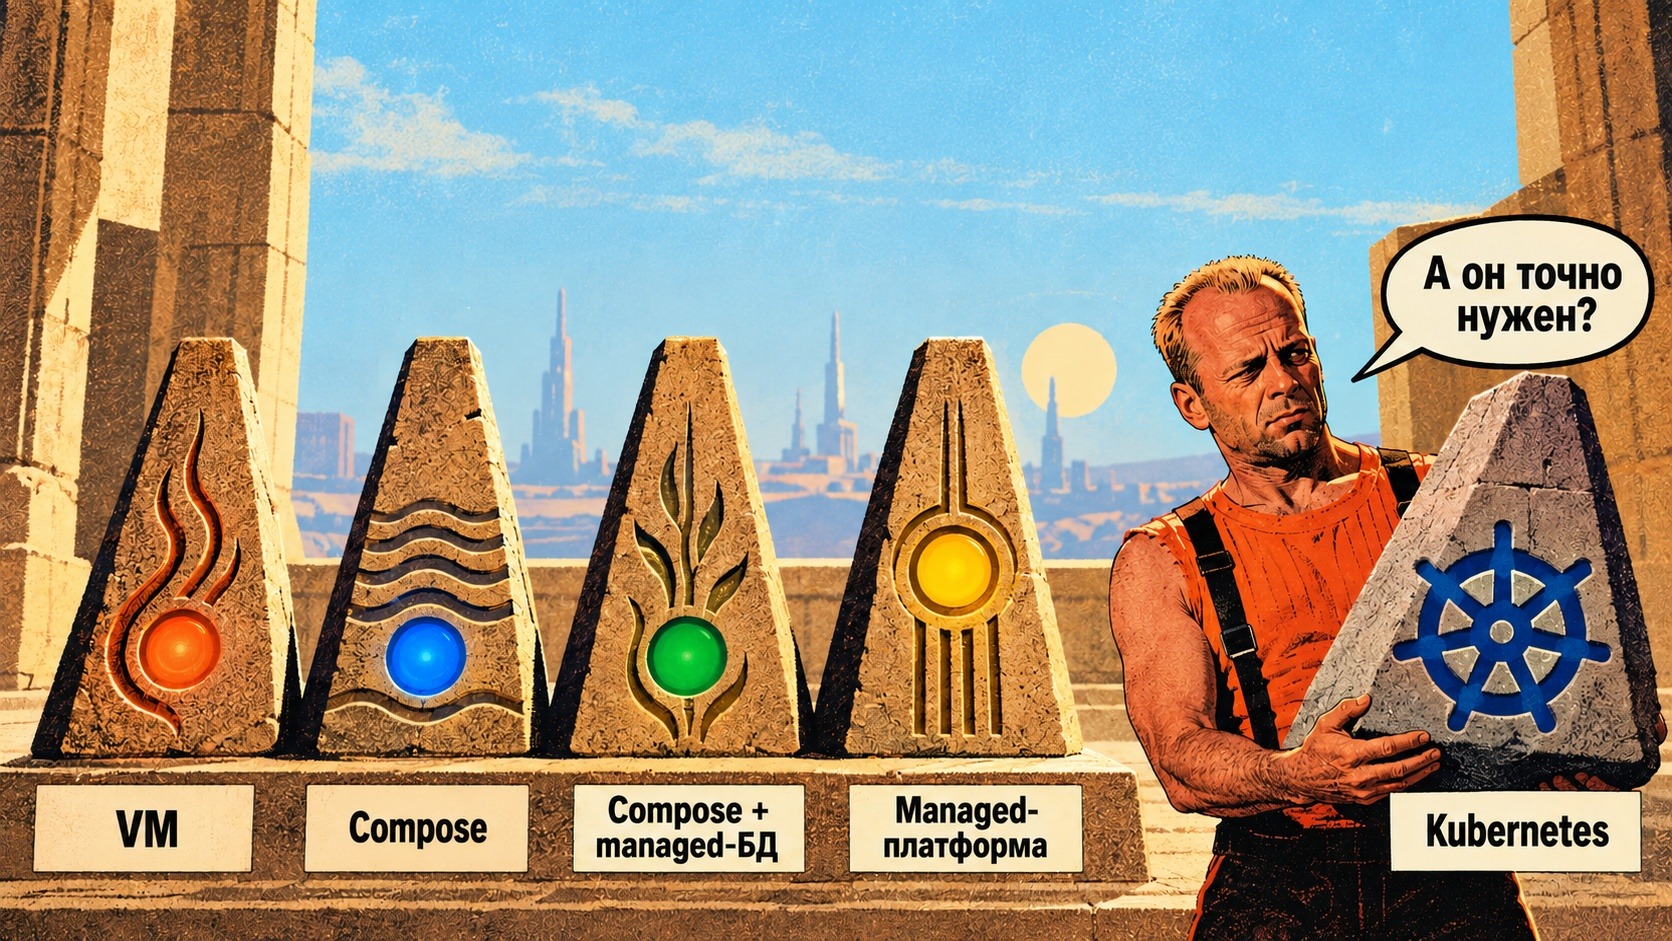
Нужен ли Kubernetes сервису с одной базой данных? Четыре способа запуска и границы между ними

У вас небольшой сервис в облаке. Он работает, но проект растет: в команде больше разработчиков, появляются фоновые задачи, пользователи ждут стабильной работы. Пора менять инфраструктуру или текущая схема еще справится?

В статье решил сравнить четыре способа запустить одно и то же приложение и разобрал случаи, когда действительно нужен Kubernetes.

Эта статья для бэкенд-разработчиков, DevOps, SRE и тимлидов. Если вы работали с виртуалками и Docker, но пока присматриваетесь к Kubernetes — велком под кат.

Узнать, нужен ли пятый элемент
  •  
  •  
❌