 Login

As search traffic dries up, Reddit announces it’s shifting to a logged-in experience
As AI transforms how people find information online, Reddit is rethinking its open-web roots to protect its audience and business.

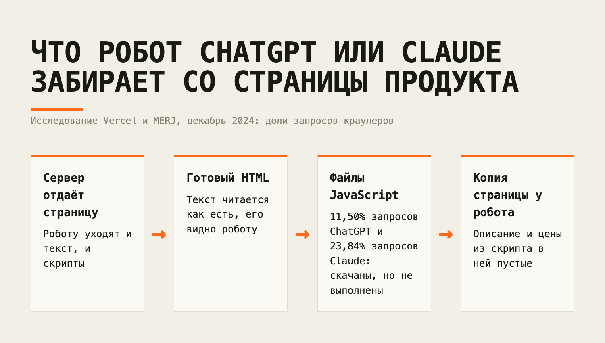
Обычно происходит вот как:
описание продукта на сайте занимает три экрана, всё разжёвано и выглядит вкусно для читателя
а ChatGPT, GigaChat, Алиса AI и Perplexity отвечают о нём общими словами или путают его с конкурентом
Вся соль в том, что нейросети читаюи не весь сайт, а несколько найденных фрагментов, и если в них нет прямого текста о том, что это за продукт и для кого он, подробности на остальных страницах ей не помогут. Часть текста может не дойти до ИИ вообще: Vercel и MERJ выяснили, что роботы ChatGPT и Claude скачивают скрипты страницы, но не запускают их, так что текст, который сайт дорисовывает в браузере, до них не доходит.
Читать далее
На Reddit пользователь рассказал о блокировке аккаунта Claude после проверки личности. По его словам, он использовал Claude Code для разработки и личных проектов.
Сервис попросил подтвердить личность. Пользователь отправил российский загранпаспорт — и сразу после этого обнаружил, что аккаунт заблокирован. Он утверждает, что живёт в Новой Зеландии по действующей четырёхлетней визе, а деньги за следующий месяц подписки с него списали всего за два дня до ограничения доступа.
Причина конкретной блокировки публично не установлена: последовательность событий сама по себе не доказывает правило «российский паспорт — автоматический бан». Но для пользователя практическая проблема уже возникла: оплаченный инструмент, на который он рассчитывал в работе, оказался недоступен.
Читать далее
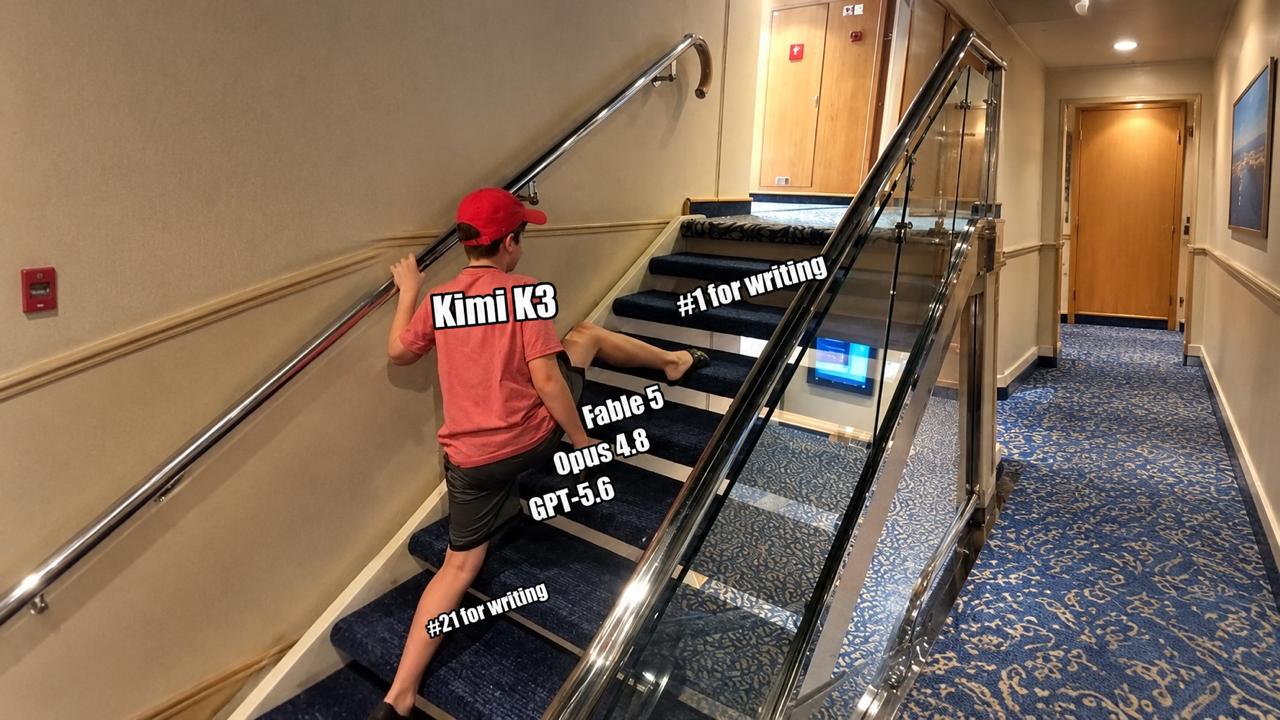
Открытые системы редко конкурируют на равных с закрытыми лидерами индустрии: у их разработчиков обычно меньше вычислительных ресурсов и данных, чем у крупных лабораторий, и это сказывается на качестве. Kimi K3 — исключение: ее веса можно скачать и развернуть у себя, а на части независимых бенчмарков она обходит закрытые решения GPT и Anthropic. В этой статье я разбираю недавно опубликованный разработчиками официальный отчет, чтобы понять, что стоит за такими результатами.
Читать далее
Знали ли вы, что Claude теперь монтирует видео? Не просто пишет сценарий или подсказывает, а делает все сам. Вы кладете в папку исходник и пишете: «Убери паузы, оговорки и слова-паразиты, оставь лучшие дубли, добавь субтитры». Через пару минут в той же папке лежит готовый ролик. Проект, который это умеет, за полгода собрал на GitHub больше 30 000 звёзд, а в соцсетях пишут, что Claude монтирует лучше специализированных нейросетей для видео.
Мы проверили, так ли это. Оказалось, что Клод вообще не смотрит ваше видео перед монтажем. Как он тогда выдает настолько качественный результат — читайте в статье.
Читать далее
Если вы делали AI-фичу на Vue, то, скорее всего, сталкивались с одним и тем же: большинство готовых инструментов для LLM-интерфейсов написаны с прицелом на React, а во Vue их приходится адаптировать или писать стриминг, tool calling и состояние чата вручную. Я сделал vue-llm — open-source библиотеку, которая закрывает это для Vue 3, Nuxt и даже Vue 2.7.
Сразу ссылки, чтобы можно было пощупать:
• Песочница без API-ключа (модель скачивается и работает прямо в браузере на WebGPU): https://vue-llm.js.org/ru/playground
• Документация на русском: https://vue-llm.js.org/ru/
• GitHub: https://github.com/dadashi44/vue-llm
• npm: npm i vue-llm
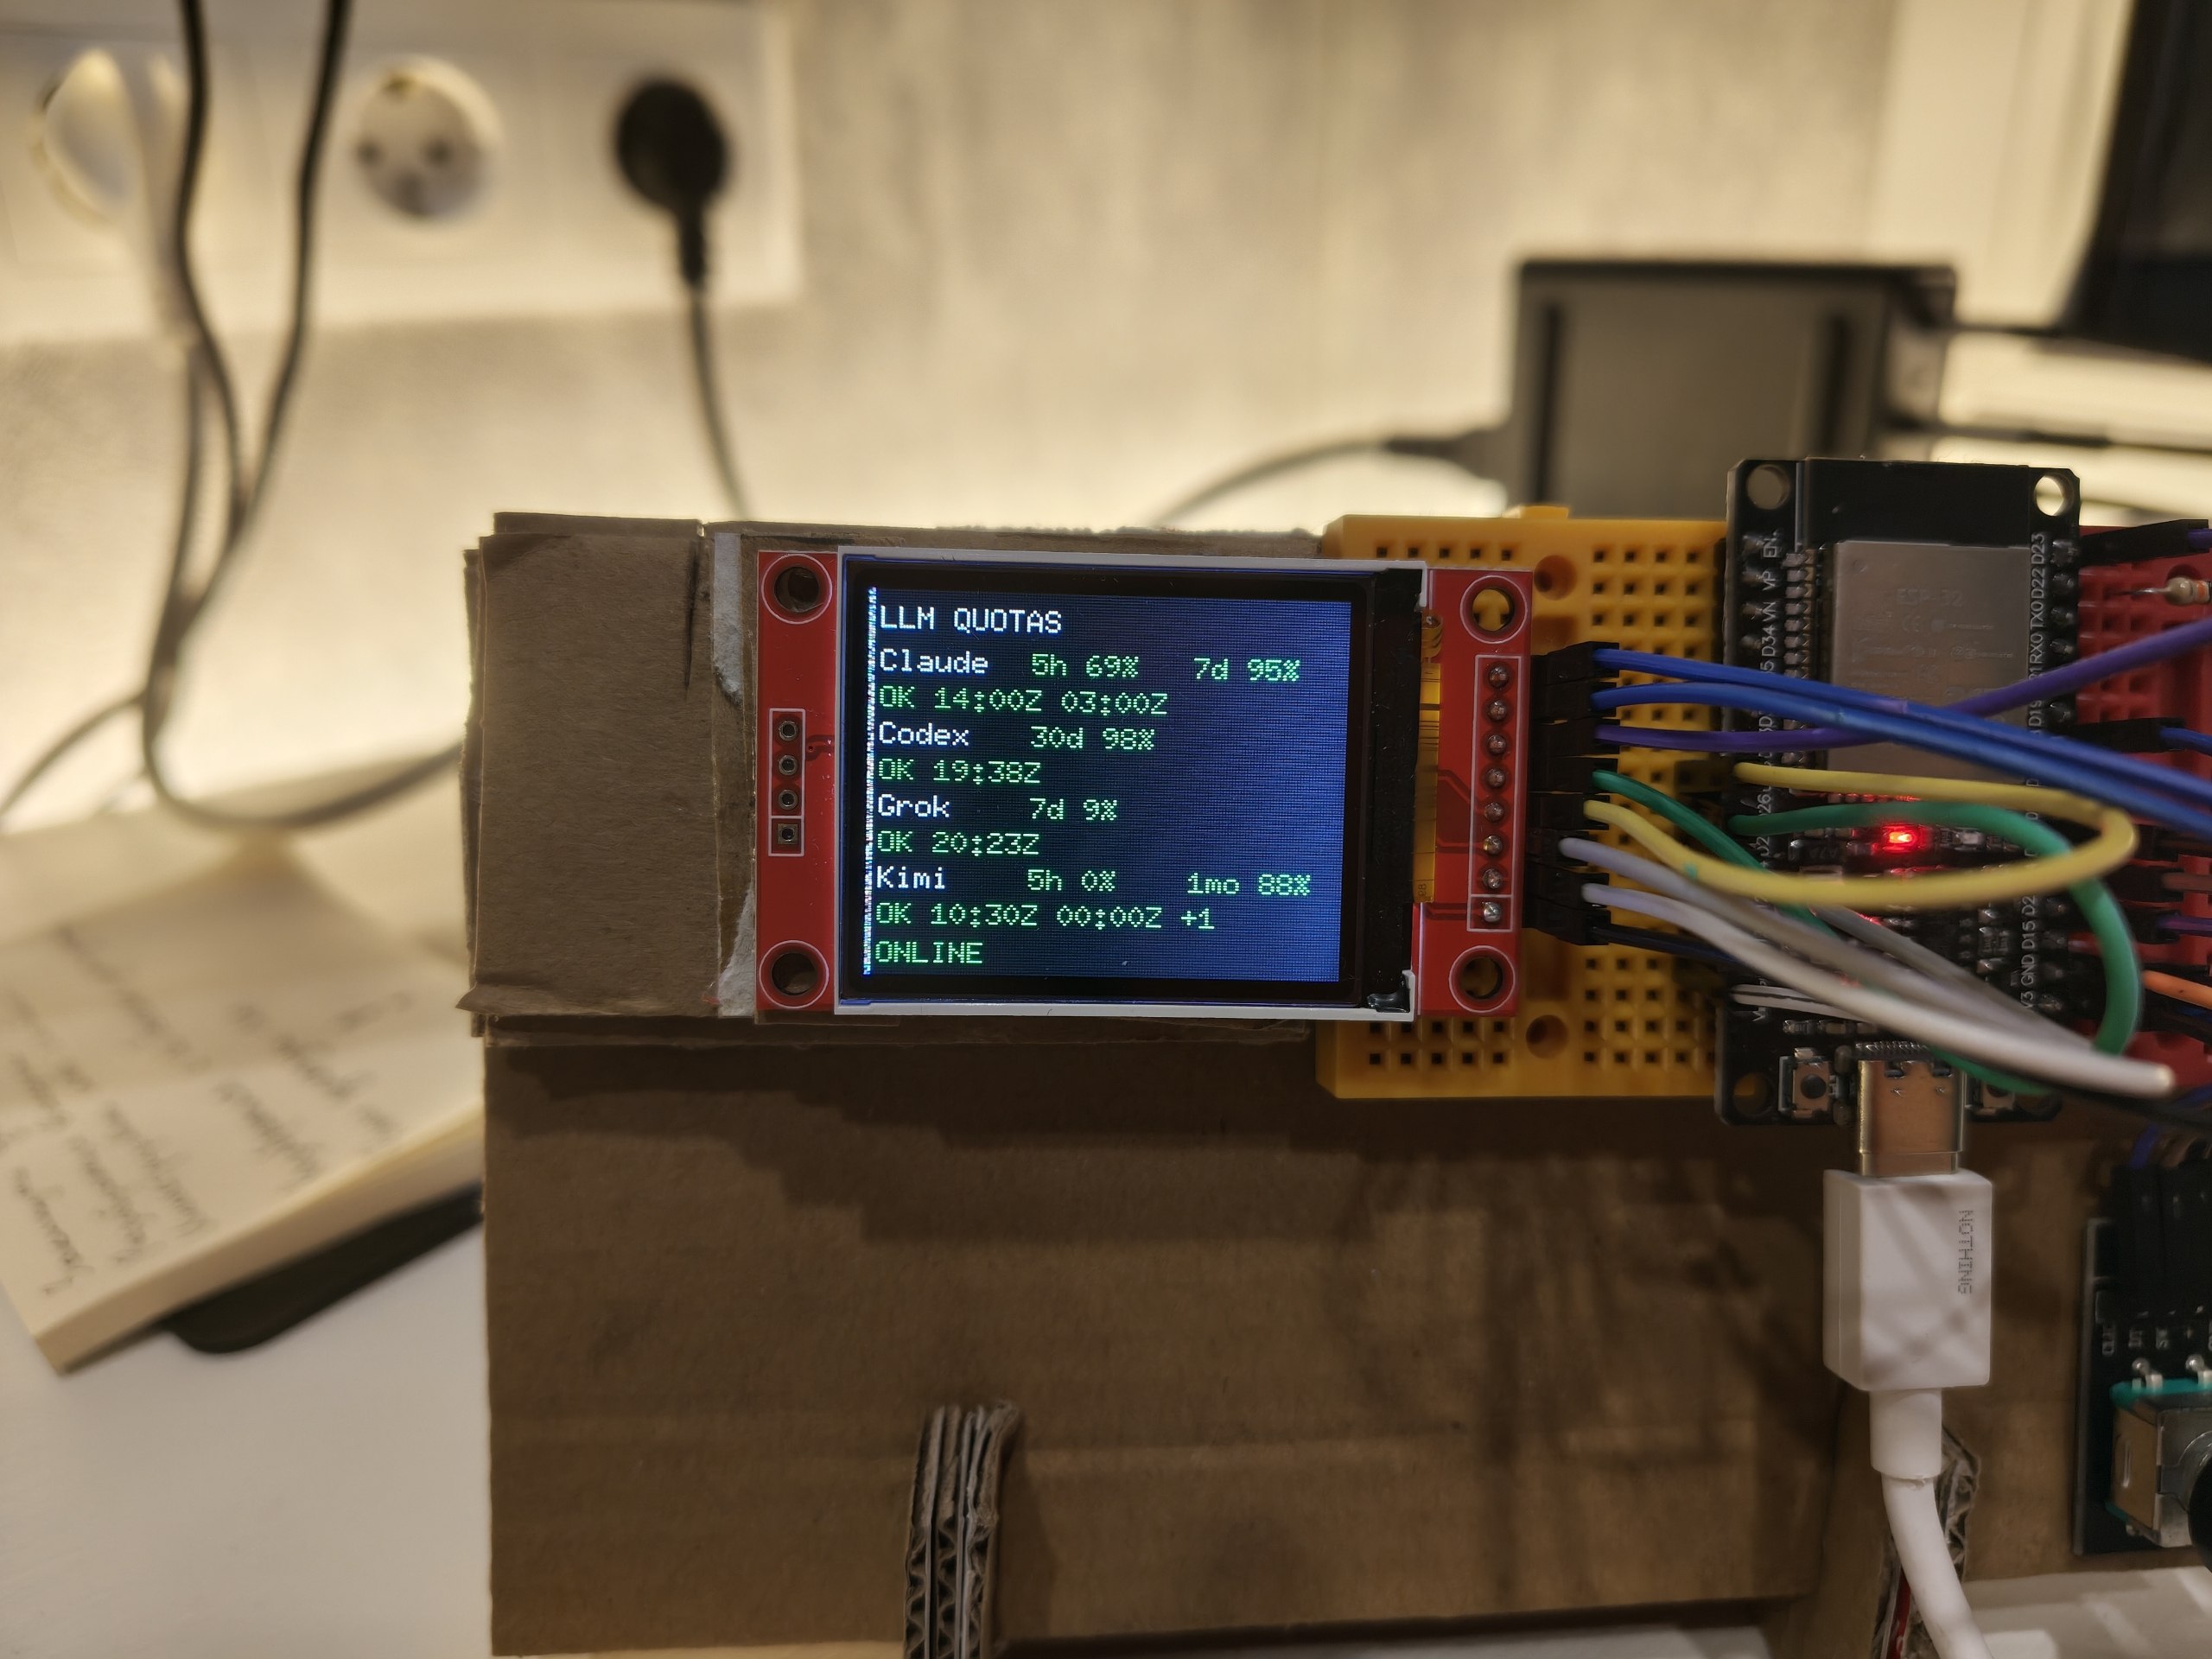
Начну с того, что еще недавно мои познания в схемотехнике балансировали на уровне непонимания различия между транзистором и резистором. Из всего арсенала, хоть как-то применимого к embedded, за душой был только Rust. Но когда на радаре замаячил так называемый встриваемый AI (машинное обучение и компьютерное зрение прямо на копеечных микроконтроллерах), - спортивный интерес взял верх. Не тратя недели на теорию, я просто доехал до радиорынка и вернулся с джентльменским набором первопроходца: ESP32, первым попавшимся экраном и энкодером. Амбиции по запуску нейросетей моментально разбились о суровую реальность первого вечера: как вообще заставить этот кусок текстолита ожить и вывести на дисплей хотя бы пару цифр?
Цифры при этом были вполне конкретные. У меня сразу несколько подписок на LLM, и у каждой свои лимиты: окно на пять часов, окно на неделю, месячный потолок. Сбрасываются они в разное время, живут на разных сайтах, а узнать остаток можно, только открыв нужную вкладку. Мне хотелось поднять глаза от клавиатуры и сразу увидеть, на что еще хватит квоты.
В итоге получился настольный монитор: нативное приложение не жрущее много памяти для Windows, которое как раз собирает лимиты четырех подписок, и маленький экран с ESP32 показывающий их прямо перед глазами.
Читать далее
Привет, Хабр! На связи Михаил Витко, менеджер PaaS-продуктов Рег.облака. Представим ситуацию. После восстановления ИИ-помощник принимает запросы и отвечает без ошибок. Но на вопрос о сроке возврата товара называет 14 дней вместо 30: база уже знает о новой редакции регламента, а поиск работает по старому индексу. Проверка доступности сервиса такую поломку не обнаружит.
В статье подробно разберем, как резервировать RAG-помощника по корпоративным документам и восстанавливать его части в согласованном состоянии. Тема обширная, поэтому мы разделили материал на две части. В первой поговорим о том, какие данные нужно сохранять, что можно пересоздать после сбоя и как организовать резервное копирование в S3, PostgreSQL и Kubernetes. А во второй обсудим, как восстановить приложение без рассогласования данных и проверить, что оно корректно работает после сбоя.
Читать далее
В RAG недостаточно найти документы на нужную тему: они должны содержать сведения, из которых можно обосновать ответ. Разберём три способа исследовать эту границу — от внешнего оценщика контекста до анализа активаций модели и испытаний на противоречивых свидетельствах.
Читать далее
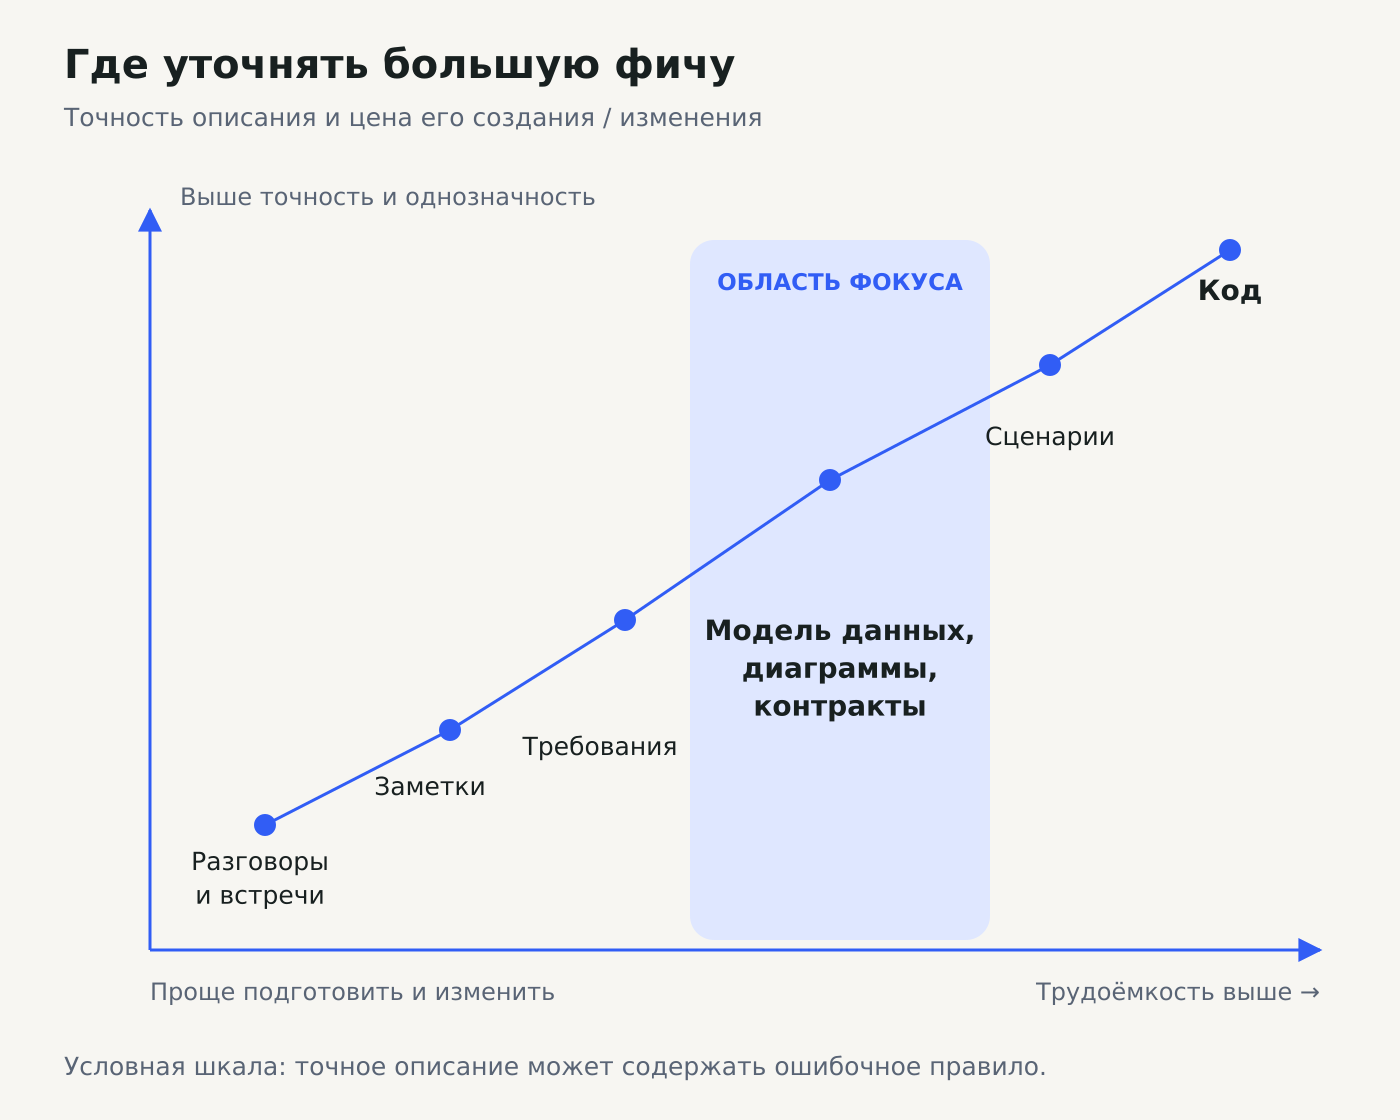
Разработка большой фичи с нуля часто начинается обманчиво легко. Заказчик объяснил идею, команда обсудила экраны, разработчики примерно представляют архитектуру. Можно приступать. Но стоит перейти от общего замысла к конкретному поведению, как появляются вопросы, на которые у каждого участника свой ответ.
Возьмём веб-систему бронирования общего оборудования. Сотрудник выбирает проектор и время, подтверждает бронь, при необходимости отменяет её. Звучит как несколько форм и CRUD. Иллюзия простоты исчезает, когда два человека одновременно бронируют один проектор, временный резерв зависает навсегда, а отменённая заявка продолжает занимать время в календаре.
Разберём, как пройти путь от такой идеи до реализации через LLM: сначала сделать правила видимыми, затем согласовать модель и контракты, после этого передавать агенту небольшие задачи. Это учебный пример, а не отчёт о внедрении или обещание определённого ускорения.
Читать далее