❌

Reading view

Книга «PostgreSQL 18. Оптимизация запросов»: основы работы планировщика в компактном формате
Запрос тормозит, а EXPLAIN ANALYZE выдаёт простыню узлов, в которой непонятно, на чём остановиться. Postgres Professional выпустила бесплатную книгу «PostgreSQL 18. Оптимизация запросов» на основе курса QPT. Она объясняет, как планировщик оценивает кардинальность и стоимость, как читать планы и какие приёмы работают для OLTP и OLAP. Читать можно хоть в метро: результаты запросов уже вплетены в текст, терминал не нужен.

Читать далее
  •  

Читать свои книги без подписок и DRM: как устроена Readora

У многих дома лежит папка с сотнями книг в FB2 — и почти ни одного удобного способа читать их где угодно. Десктопные читалки не синхронизируют прогресс, онлайн-сервисы требуют подписку и не принимают «свои» файлы, а связка Calibre с облаком — конструктор для энтузиаста. Рассказываем, как эту проблему решили браузером, PostgreSQL и открытым кодом — и почему в итоге всё свелось к скучному и предсказуемому стеку.

Но обо всём по порядку.

Погнали
  •  

Потерянные ключи шифрования, или изучение атомарности в Cassandra

Привет, Хабр! На связи системный аналитик Илья Глазунов и разработчик Кирилл Дунаев. Мы работаем с платформой аналитического карточного хранилища Т-Банка. Попутно открываем все новые грани одного из главных компонентов нашего детища — Apache Cassandra. 

Мы уже изучили тонну материалов, сами стали носителями знаний, делимся ими в команде и на Хабре. Но не перестаем натыкаться на интересные механики и особенности Cassandra, которые приходится разбирать по принципу «с миру по нитке». 

Та механика, о которой пойдет речь, могла проявиться только в системе со специфическим дизайном, предназначенной для очень конкретных задач, при значительной нагрузке на запись и высоком коэффициенте параллельности.

В статье разберем, почему утверждение «Cassandra — колоночная БД» частично верное. Приоткроем занавес, как база данных работает с мета-данными и объединением неизменяемых файлов при высокой пишущей нагрузке. А еще подискутируем на тему понятия атомарности операций во вселенной Apache Cassandra и разберемся, причем же тут UDT и frozen UDT. 

Читать далее
  •  

PostgreSQL на 1 ТБ: сколько стоит облако и выделенный сервер

Облачные провайдеры удобны в использовании, но когда базы данных разрастаются до огромных размеров, становится страшно смотреть на выставленные счета. Один из способов сократить расходы — перенести базу на выделенный сервер. Кроме экономии, у выделенных серверов масса преимуществ: полный контроль над аппаратными ресурсами, отсутствие соседей по гипервизору, предсказуемая производительность. Именно поэтому компании успешно переводят свои тяжёлые проекты на выделенные серверы.

Возьмём PostgreSQL-базу объёмом 1 ТБ и сравним, во сколько обойдётся её размещение в AWS и на выделенном сервере. Заодно рассмотрим варианты переноса данных и расходы, которые стоит учесть помимо аренды.

Читать далее
  •  

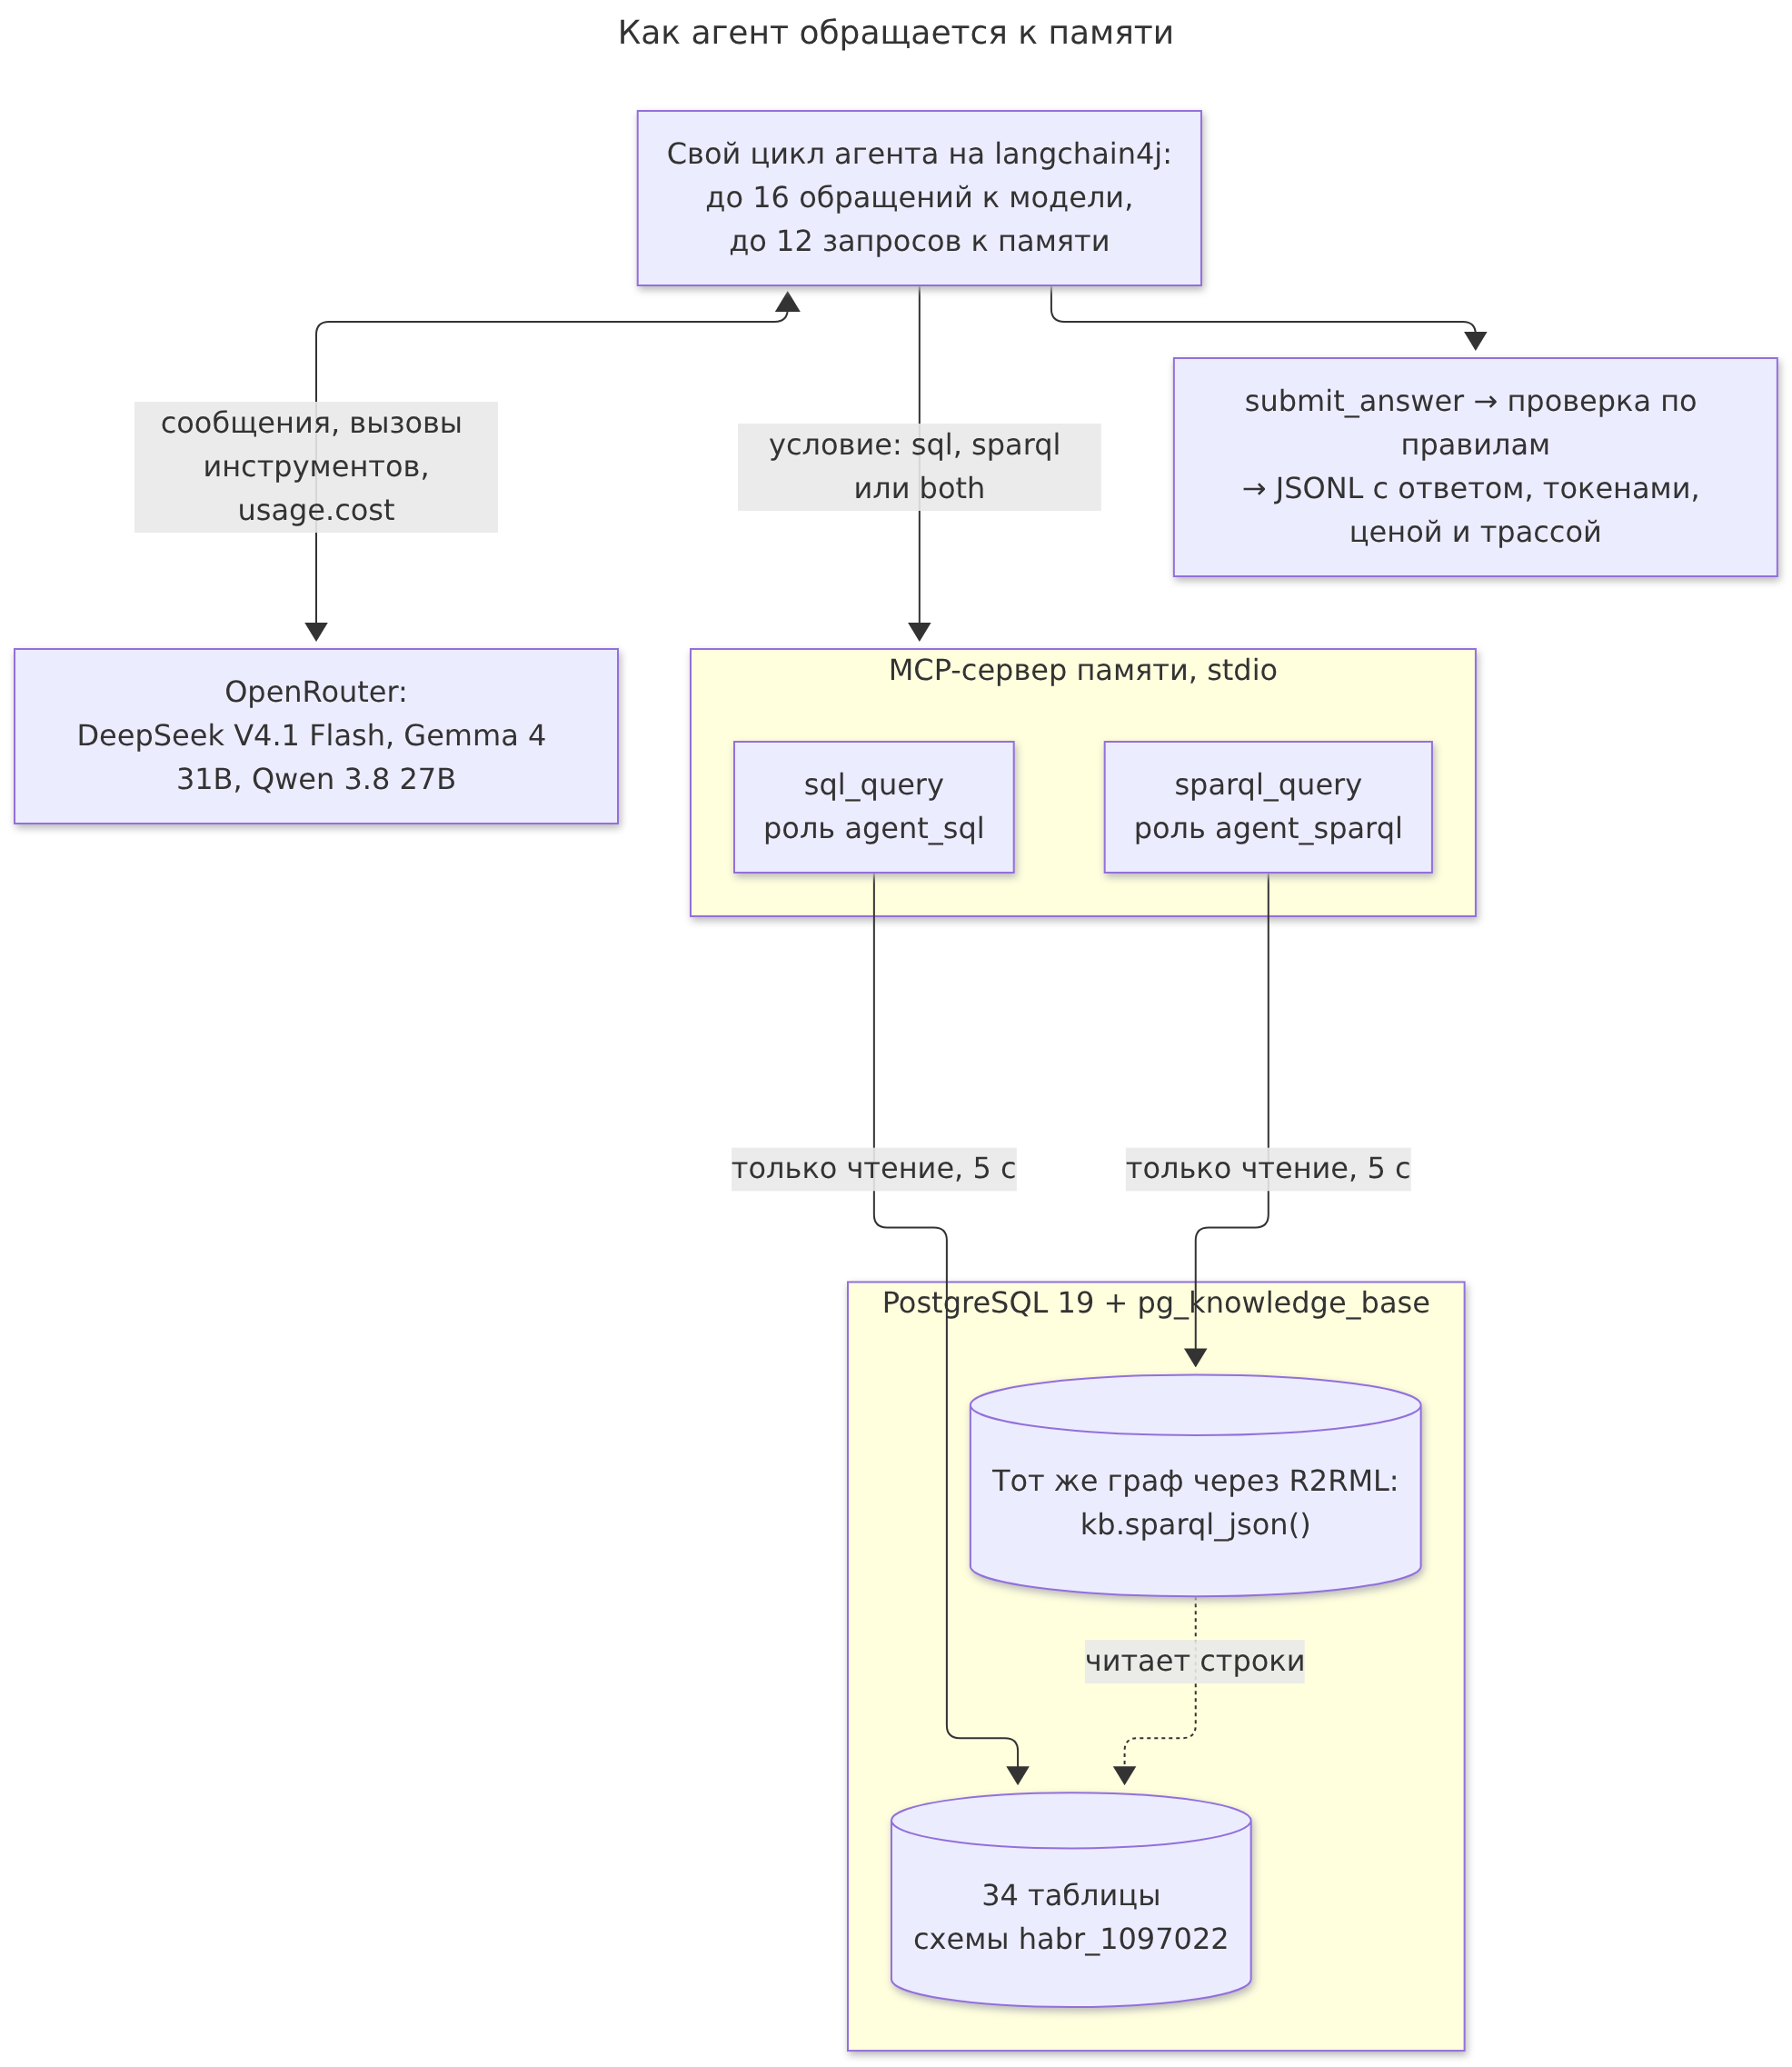
На каком языке ИИ-агенту искать по своей памяти: SQL или SPARQL?

Память агентов в тренде с того момента как они появились, чтобы бороться с галюцинациями и давать ответы и решения LLM на собственной информации. Как лучше запрашивать информацию из таблиц или из графа часто решается на вере, начитавшись постов в интернет без своих экспериментов и измерений. В исследовании Sequeda и соавторов GPT-4 отвечал на вопросы по корпоративной SQL базе верно в 16% случаев, а по графу знаний поверх этой же базы в 54%, где у графа была онтология с описанием, а у SQL схемы только DDL типы и названия таблиц/колонок.

В моем GraphRAG одна и та же информация представлена в двух разных формах. Данные из статьи “Мой PostgreSQL быстрее твоего и почти догнал ClickHouse” извлек в 34 таблицы PostgreSQL, а в граф это превратил с помощью отображения R2RML. Подключил обе формы представления знаний к агенту по MCP и задал ему 15 вопросов о статье: через SQL, через SPARQL и дал еще выбор агенту из двух этих видов сразу. В моем эксперименте агент по очереди запускался на трех LLM с открытыми весами. Их можно развернуть на своей инфраструктуре или ноутбуке и данные и вопросы не уйдут провайдеру в логи или агрегатору между вами и LLM.

Таже я проверил и рассчитал что лучше для векторного хранения и семантического поиска: lance или pgvector. Поделюсь своими измерениями на современных моделях как лучше искать и в чем хранить знания.

Обнаружил в эксперименте как DeepSeek придумал SQL-инъекцию чтобы ответить на мой вопрос.

Читать далее
  •  

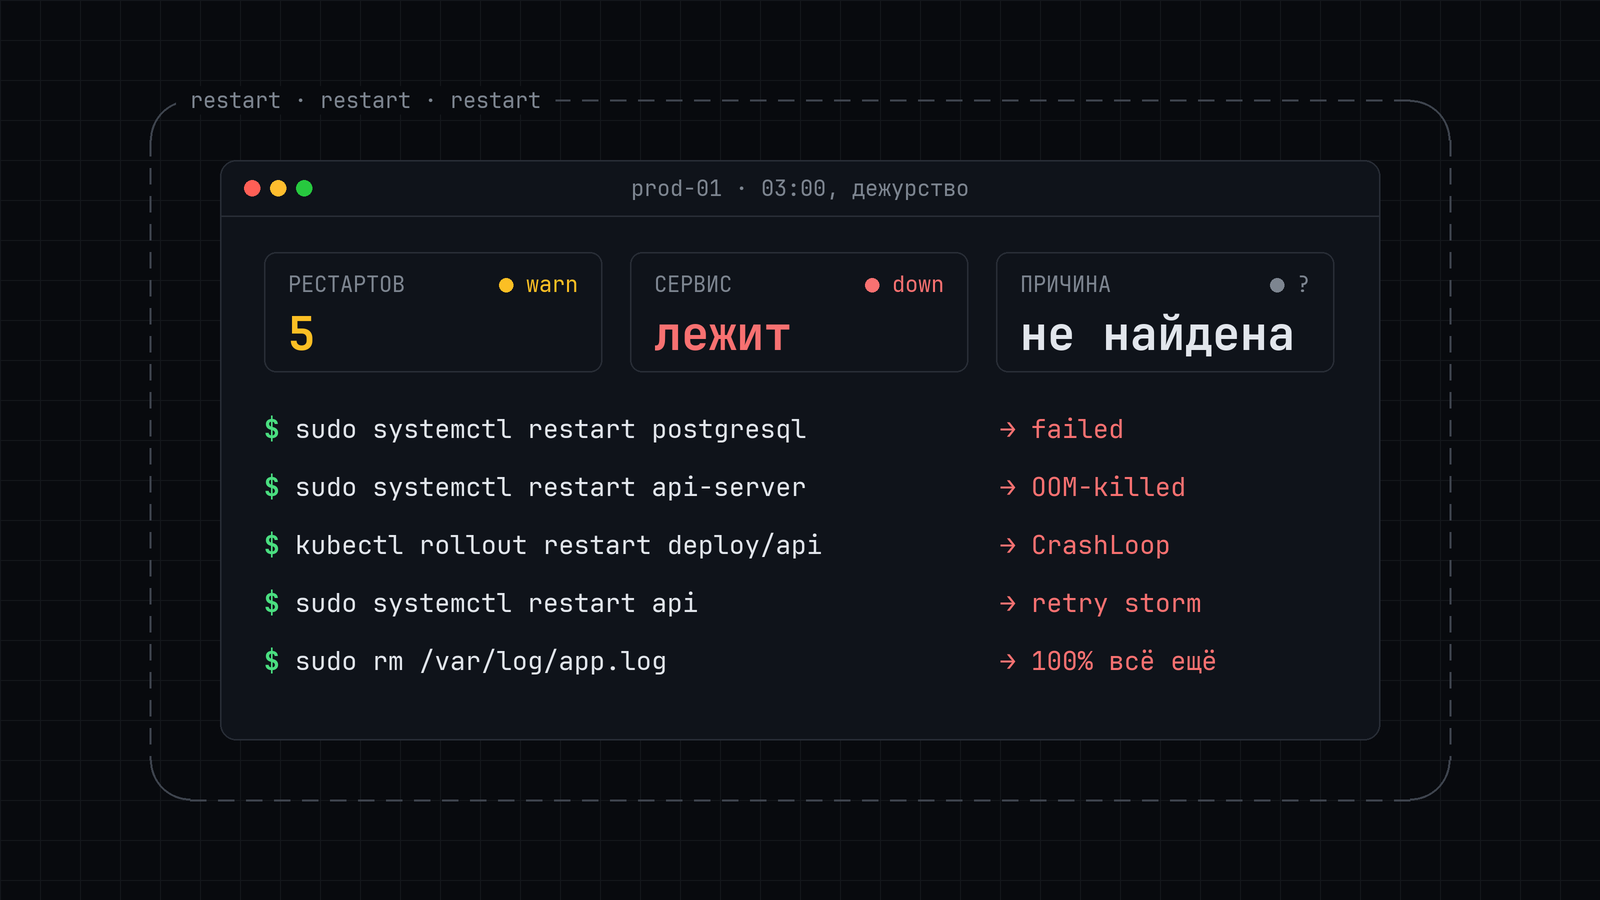
Перезапустил — и стало хуже: 5 инцидентов, которые не лечатся рестартом

Три часа ночи, API отвечает 500, и рука сама набирает systemctl restart. Иногда это помогает, но есть инциденты, где рестарт добивает то, что ещё работало, и стирает улики. Пять таких: битый конфиг, OOM killer, retry storm, CrashLoopBackOff и диск, забитый логом, — с командами, которые находят настоящую причину, и шпаргалкой на одну таблицу.

Читать далее
  •  

Эй, девелопер, дизайн твоего кода никуда не годится

Вы когда-нибудь читали такое сообщение от кодинг-агента? Мне не приходилось, а жаль.

Каждый раз, когда я довожу код, сгенерированный AI по моему ТЗ, я прогоняю его через ревью несколькими агентами с разными ролями и точками зрения — что-то вроде взгляда нескольких людей с разным опытом. И почти всегда получаю пачку разнокалиберных замечаний, от мелких до критических. Казалось бы, что сложного: открой новую сессию, скорми ей замечания, дай исправить, прогони ревью снова.

У этой замечательной стратегии, однако, есть одно слабое место: а мы уверены, что такой процесс сходится?

Читать далее
  •  

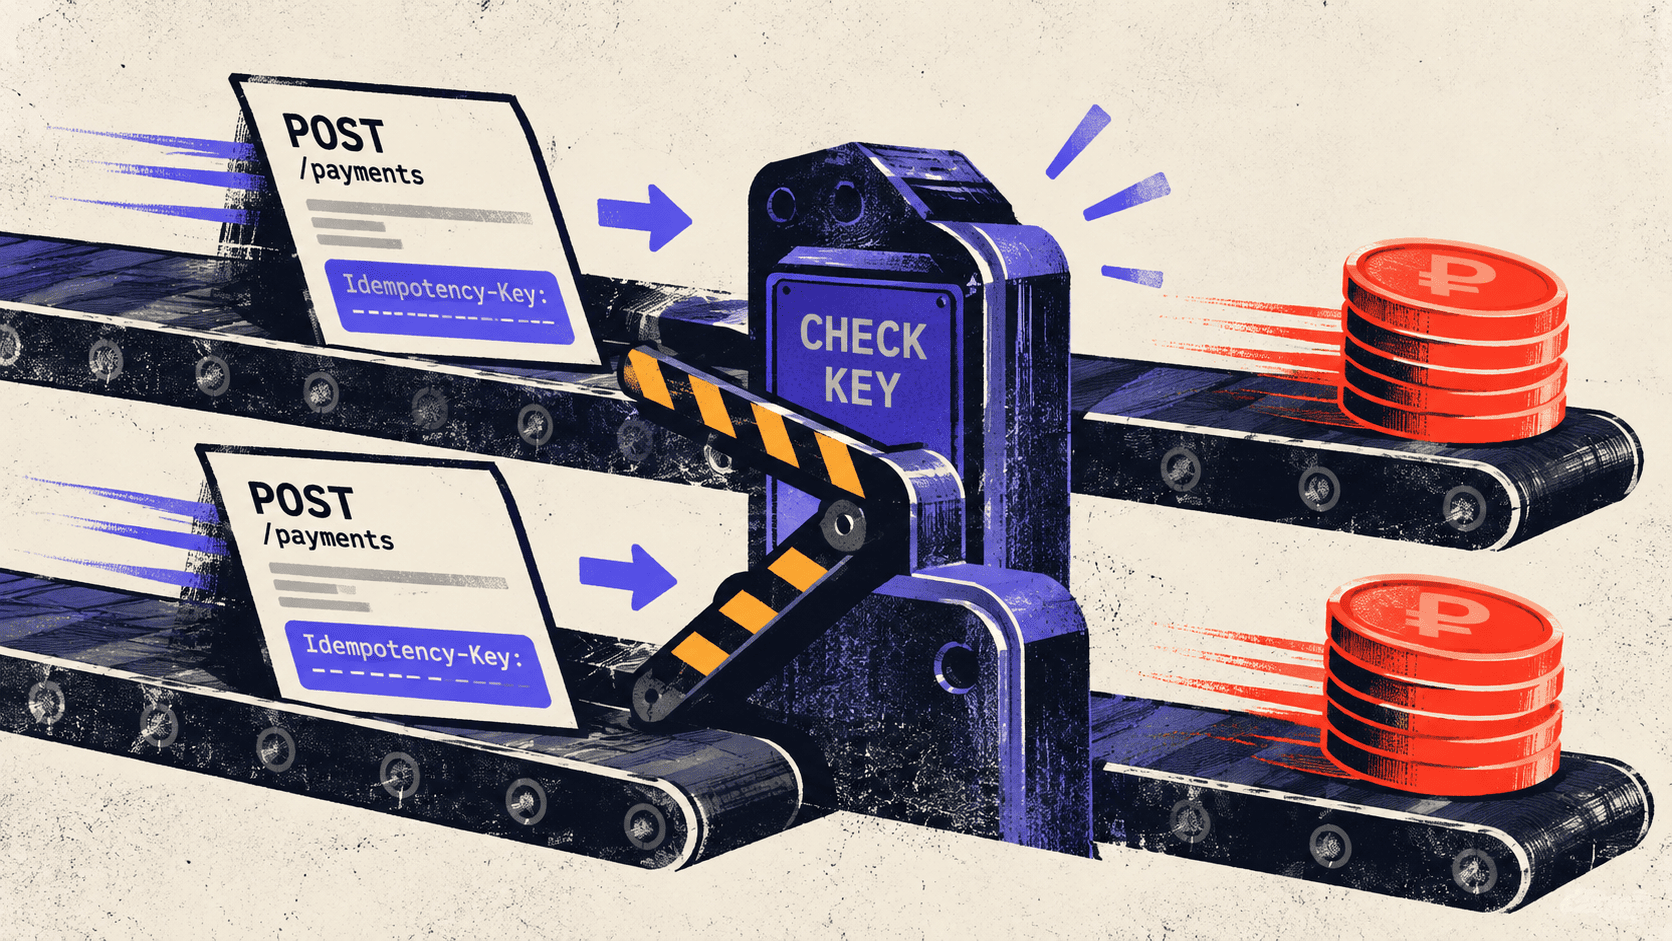
Почему Idempotency‑Key не спасает от двойного списания и как это исправить

Клиент отправил платёж, не дождался ответа и повторил запрос. На сервере предусмотрен Idempotency-Key, тесты проходят, но деньги всё равно списываются дважды. Проблема возникает, когда второй запрос приходит до завершения первого: оба обработчика успевают проверить ключ и запустить оплату.

Разберём, как закрыть эту гонку с помощью PostgreSQL, что делать при падении процесса и почему даже правильно реализованная идемпотентность внутри сервиса не всегда спасает от повторного списания.

Разобрать решение
  •  
❌