❌

Reading view

ymcp, или как подружить агентов с YouTrack, если ты не админ

Всё началось с того, что я в очередной раз копировал описание задачи из YouTrack в Claude Code. Потом комментарии к ней. Потом ещё один комментарий, который кто‑то оставил, пока я копировал первые. Потом ждал, пока агент напишет код, открывал PR, возвращался в задачу, вставлял ссылку, менял статус на Fixed — и шёл за следующей.

В какой‑то момент я понял, что из всей этой цепочки самая бесполезная её часть — это я. Агент умеет писать код, YouTrack умеет хранить задачи, а я работаю буфером обмена с ногами.

Решение вроде бы очевидное: дать агенту доступ к трекеру через MCP, и пусть сам читает, сам пишет, сам двигает задачи. Ну чтож, давайте подключим.

Читать далее
  •  

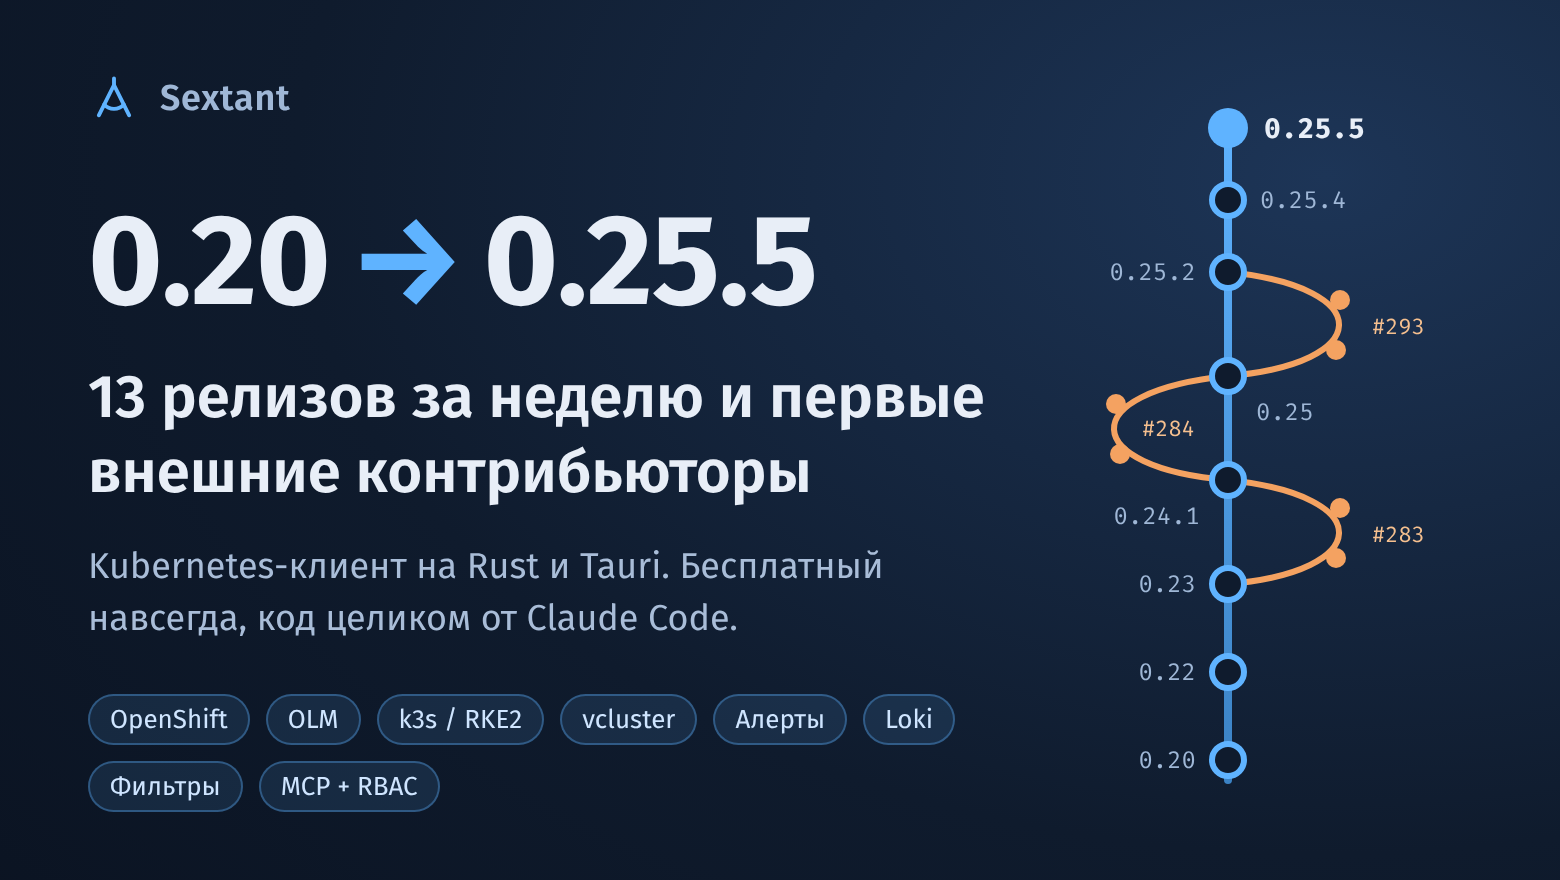
13 релизов за неделю: OpenShift, алерты, фильтры и первые внешние контрибьюторы Sextant

В прошлой статье про Sextant в конце стоял роадмап на четыре версии. Все четыре вышли к 23 октября, а за ними — ещё восемь релизов: алерты из Prometheus и Alertmanager, логи удалённых подов из Loki, OpenShift, OLM, k3s/RKE2, vcluster и фильтры в таблицах. Всего за неделю — 13 релизов, от 0.20.0 до 0.25.5.

Но главное в этой неделе — сообщество. Первые внешние pull request’ы вошли в релизы, идея из внешнего PR сократила память на отслеживаемый объект в пять раз, а целая версия 0.25.5 выросла из одного обсуждения про AI-агентов на кластерах с ограниченным RBAC.

Sextant — десктопный клиент Kubernetes на Rust и Tauri 2, замена Lens без аккаунта и телеметрии, со встроенным MCP-сервером для AI-агентов. Он бесплатный и таким останется. Весь его код сгенерирован Claude Code: человек ставит задачи, принимает архитектурные решения и делает ревью, а каждое изменение много раз проходит тесты.

Под катом — дайджест релизов, обзор нового по темам и благодарности всем, кто присылал баги, идеи и код.

Читать далее
  •  

Deep Research и MCP Mobbin — нитро для поиска референсов

Привет, Хабр! Я Женя Горбач, продуктовый дизайнер в Альфа-Метрике, аналитическом продукте Альфа банка. Найти рефы для авторизации, оформления заказа или перевода — задача вполне понятная. Но что делать, если проектируешь сценарий, который редко встречается в других продуктах, а решения прямых конкурентов тебе не подходят?

Недавно я столкнулся именно с такой задачей во время редизайна одного из разделов нашего сервиса — каталога событий. 70% пользователей бросали загрузку событий, и нам предстояло выяснить, почему, и помочь им. Спойлер: более удобное решение получилось благодаря тому, что мы выпилили часть интерфейса. В этой статье расскажу, как с помощью ChatGPT, Deep Research и Mobbin через MCP я не только ускорил, но и качественно улучшил процесс поиска решения.

Читать далее
  •  

Вайб-кодинг вместо унылых ТЗ: как автономные ИИ-агенты ускоряют разработку игр

В геймдеве идеи стоят дешево. Дорого стоит возможность их пощупать. Классический цикл прототипирования, к которому мы привыкли, выглядит примерно так: тратишь несколько дней на монументальный диздок, расписываешь каждую кнопку, каждое нажатие и относишь это всё программистам. Они уходят кодить на неделю-две. А потом, когда возвращаются, вы запускаете черновой билд и понимаете, что играть в это вообще не прикольно: механики не затягивают, интерфейс непонятный, и вообще идея была мёртвой с самого начала. Но время и силы уже потрачены, и их не вернуть.

«Как же хорошо, что человечество уже придумало нейросети», — подумали мы в Magnus Tech и полностью отказались от ручного написания текстовых ТЗ для проверки гипотез. Потому что зачем описывать механику буквами, если ее можно быстро навайбкодить? Теперь для тестирования новых фичей мы не пишем таски на десятки страниц, мы собираем черновой прототип на примитивах за пару часов и сразу его тестируем. В результате время от задумки до первого теста сократилось с недель до нескольких часов.

Но чтобы такая схема работала, обычного чат-бота в соседней вкладке браузера недостаточно. Нейросеть должна сама шерстить папки с проектом, ковыряться в скриптах и понимать структуру движка. Чтобы показать, как это устроено на практике, мы поговорили с Иваном Дворяновым, продюсером игрового направления в Magnus Tech. В этой статье делимся его опытом и рассказываем, как мы пустили Claude напрямую в Unity через MCP, почему вайб-кодинг всё равно требует жесткого планирования и в каких задачах лучше не доверяться ИИ, а по старинке работать руками.

Читать далее

  •  

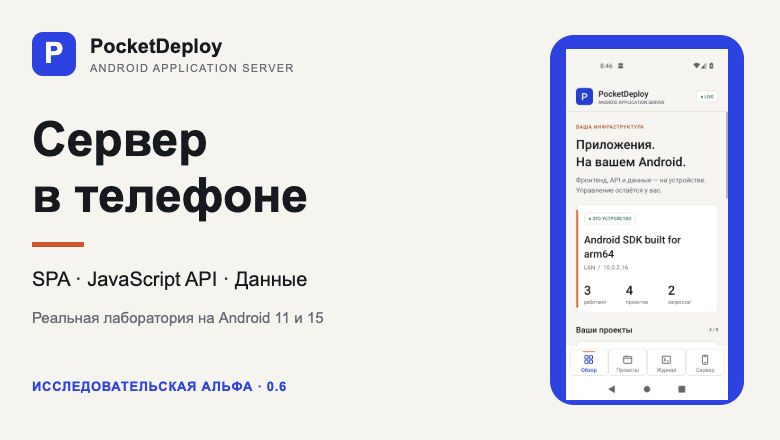
PocketDeploy: веб-приложение и свой Bluesky PDS на Android — что получилось и где пока пределы

PocketDeploy запускает сайт и официальный Bluesky PDS внутри Android. Разбираю границы встроенного режима и Termux, HTTPS-шлюз, федерацию, резервную копию и известные проблемы безопасности. Реальные экраны, протоколы и неудачный опыт обслуживания облачного эмулятора на 2 ГБ. Следующий этап — воспроизводимый запуск и восстановление; готовность к работе 24/7 ещё не доказана.

Разобрать архитектуру
  •  

Вызываем паранойю у ИИ-агентов: заменит ли MCP AppSec?

Не писал на Хабре 15 лет — всё ждал «свободной недельки». Дождался: за 7 дней, ~210 млн токенов и 8 литров кофе собрал локальный MCP-сервер, который запускает сканеры, ведёт базу файндингов и снимает с безопасника рутину триажа. Под катом: как агенты встраиваются в SSDLC, что происходит под капотом MCP, бенчмарк семи локальных моделей на одной RTX 4060 Ti — с неожиданным победителем — и ответ на главный вопрос, вытеснят ли агенты классический AppSec. Спойлер: рутину — да, архитектуру — нет. Осторожно, сарказм!

Митигировать нельзя, пофиксить
  •  

На каком языке ИИ-агенту искать по своей памяти: SQL или SPARQL?

Память агентов в тренде с того момента как они появились, чтобы бороться с галюцинациями и давать ответы и решения LLM на собственной информации. Как лучше запрашивать информацию из таблиц или из графа часто решается на вере, начитавшись постов в интернет без своих экспериментов и измерений. В исследовании Sequeda и соавторов GPT-4 отвечал на вопросы по корпоративной SQL базе верно в 16% случаев, а по графу знаний поверх этой же базы в 54%, где у графа была онтология с описанием, а у SQL схемы только DDL типы и названия таблиц/колонок.

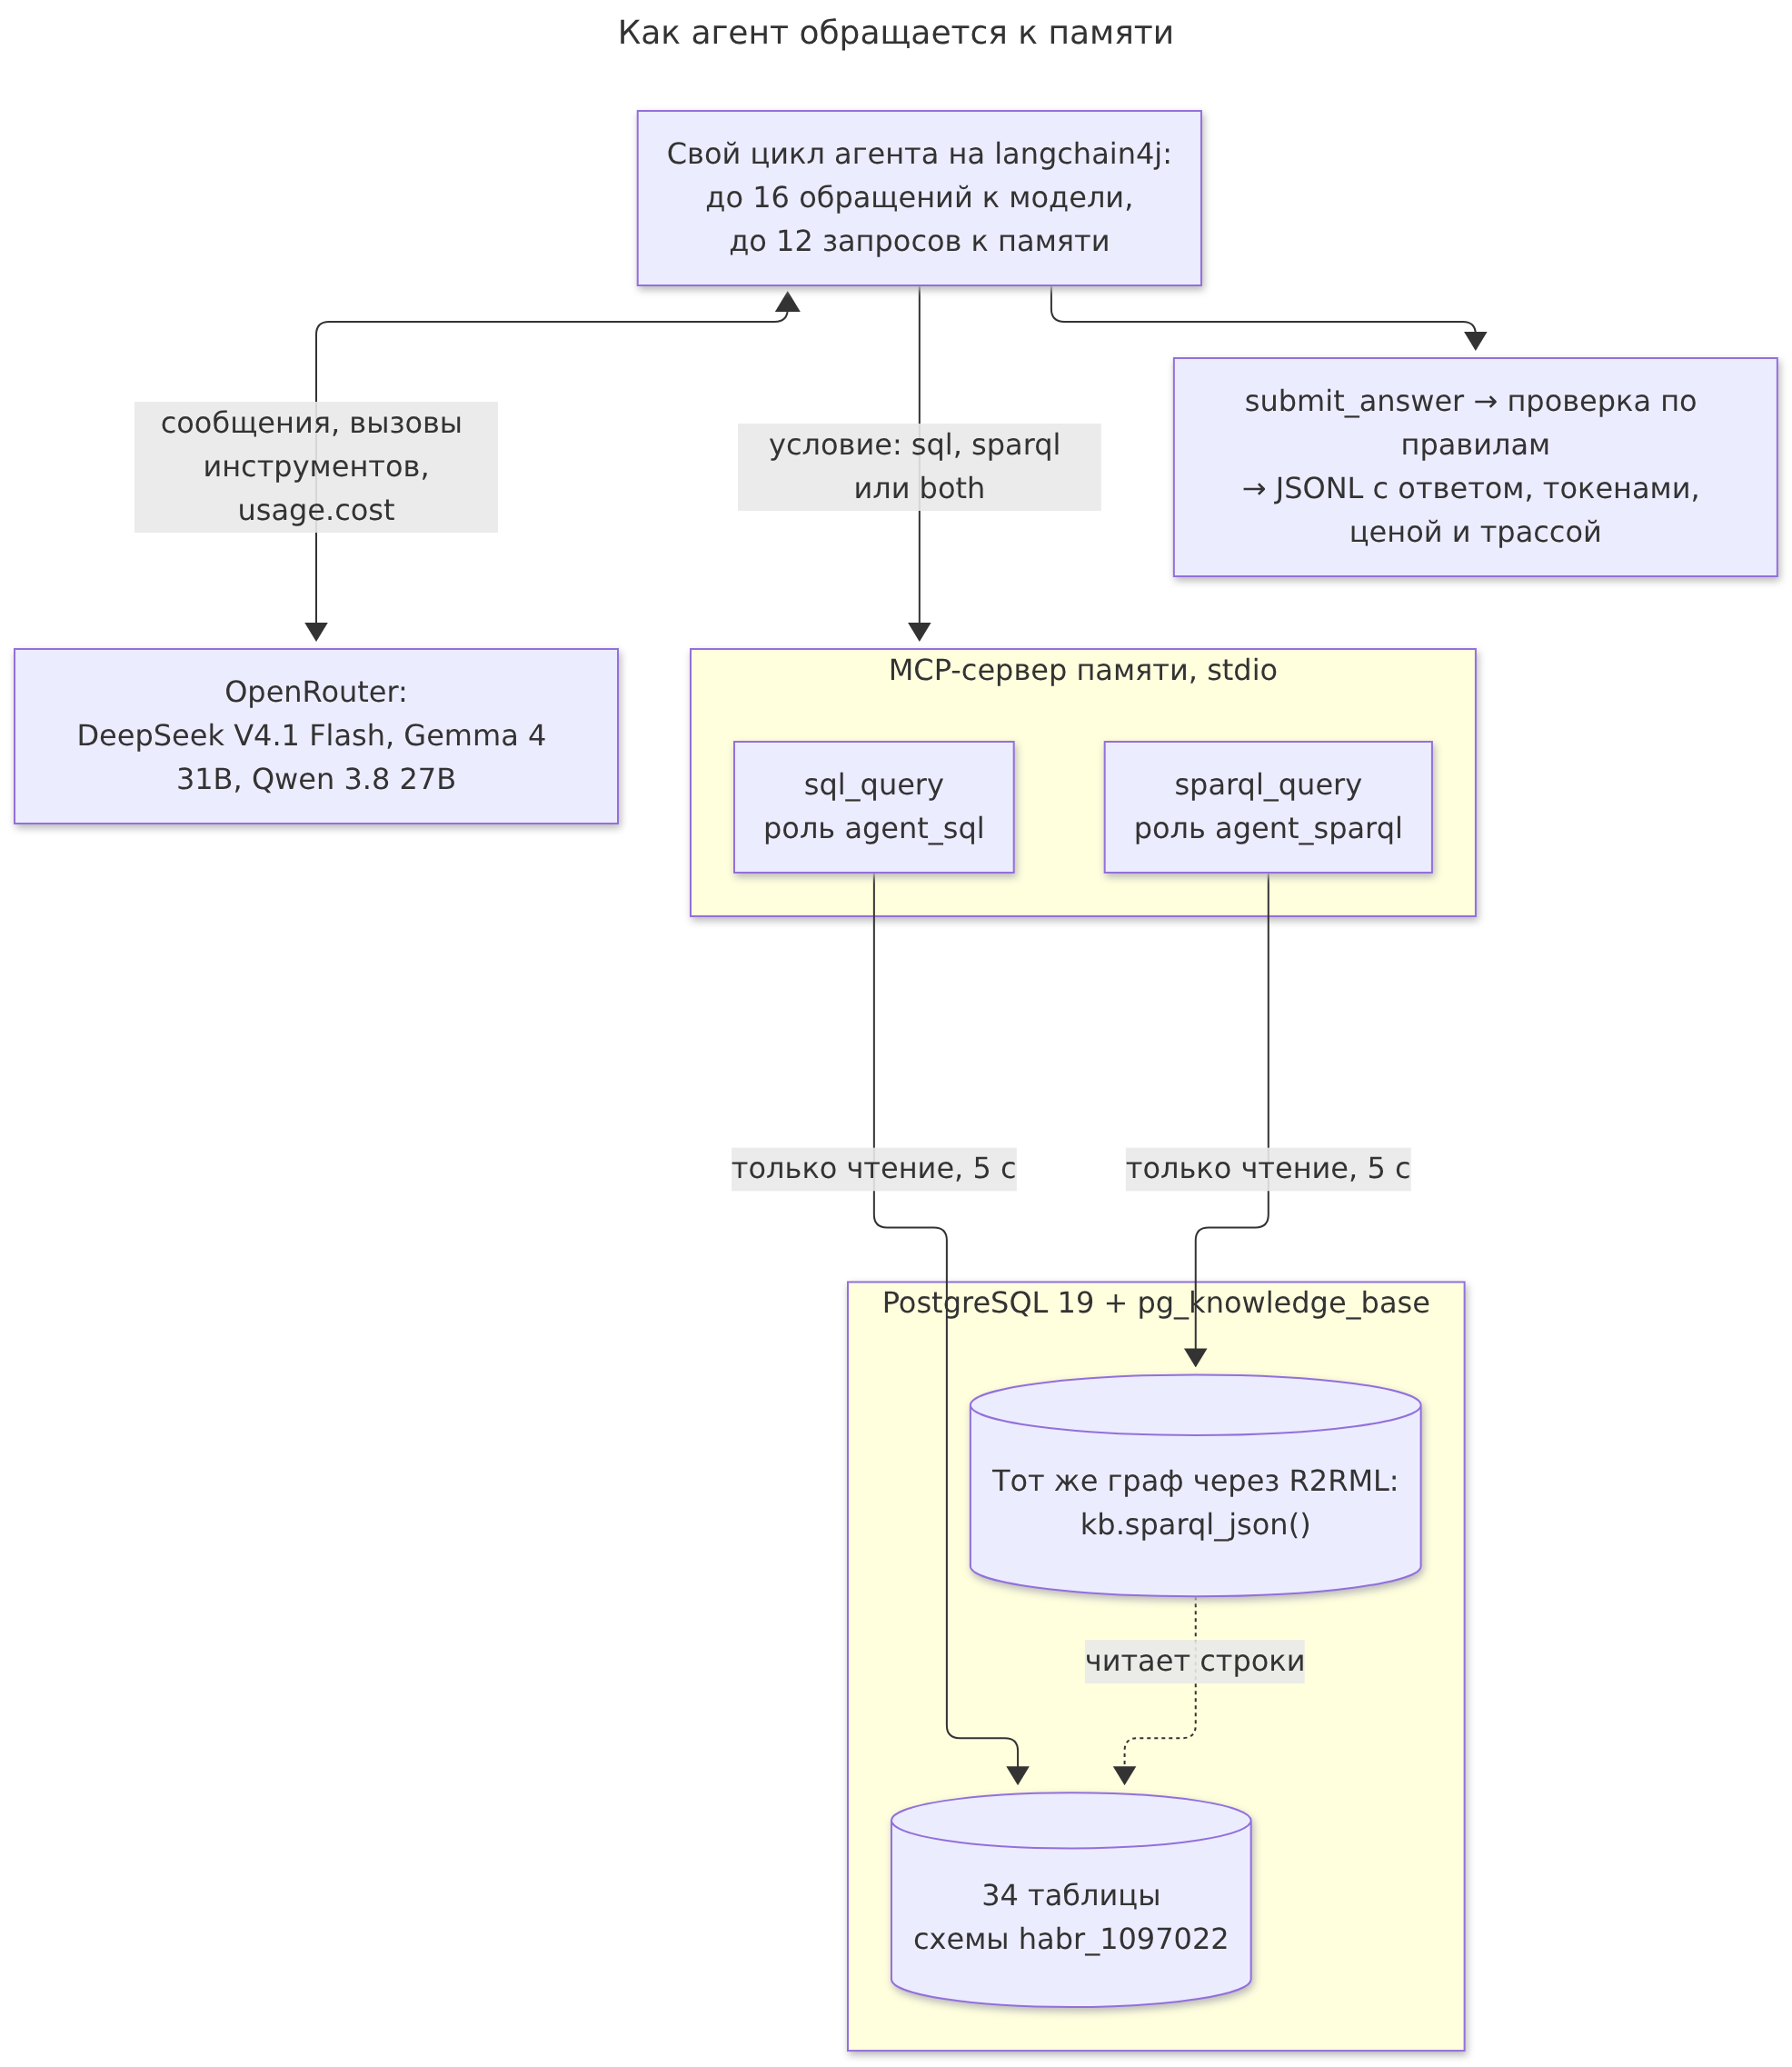
В моем GraphRAG одна и та же информация представлена в двух разных формах. Данные из статьи “Мой PostgreSQL быстрее твоего и почти догнал ClickHouse” извлек в 34 таблицы PostgreSQL, а в граф это превратил с помощью отображения R2RML. Подключил обе формы представления знаний к агенту по MCP и задал ему 15 вопросов о статье: через SQL, через SPARQL и дал еще выбор агенту из двух этих видов сразу. В моем эксперименте агент по очереди запускался на трех LLM с открытыми весами. Их можно развернуть на своей инфраструктуре или ноутбуке и данные и вопросы не уйдут провайдеру в логи или агрегатору между вами и LLM.

Таже я проверил и рассчитал что лучше для векторного хранения и семантического поиска: lance или pgvector. Поделюсь своими измерениями на современных моделях как лучше искать и в чем хранить знания.

Обнаружил в эксперименте как DeepSeek придумал SQL-инъекцию чтобы ответить на мой вопрос.

Читать далее
  •  

Как я подключил рабочие чаты Telegram к ИИ-ассистенту через MCP

В рабочих чатах Telegram рядом живут сообщения о релизах, вопросы подрядчиков, согласования и короткие «посмотри, пожалуйста». Чтобы понять, что требует внимания, приходится открывать несколько чатов и восстанавливать контекст из отдельных реплик.

Я сделал TelegramMCP — открытый сервер, который подключает личный аккаунт Telegram к ИИ-приложению с поддержкой MCP. Ассистент получает инструменты для чтения папок и чатов, поиска бесед и отправки текстовых сообщений. Уже поверх этих инструментов его можно попросить собрать главное из выбранной переписки или подготовить ответ.

В статье расскажу, как устроено подключение через TDLib, зачем понадобилась поддержка папок, как запустить проект и какие проблемы ещё остаются.

Читать далее
  •  
❌