❌

Reading view

[Перевод] HTML-in-Canvas в Chrome 157: интерактивный DOM в 2D, WebGL и WebGPU

После успешного origin trial API HTML-in-Canvas официально вышел в стабильной версии Chrome 157. Он объединяет интерактивность и доступность DOM с производительностью и попиксельным управлением <canvas>. Так возможности браузера можно использовать вместе с графикой canvas, ускоренной на GPU.

Читать далее
  •  

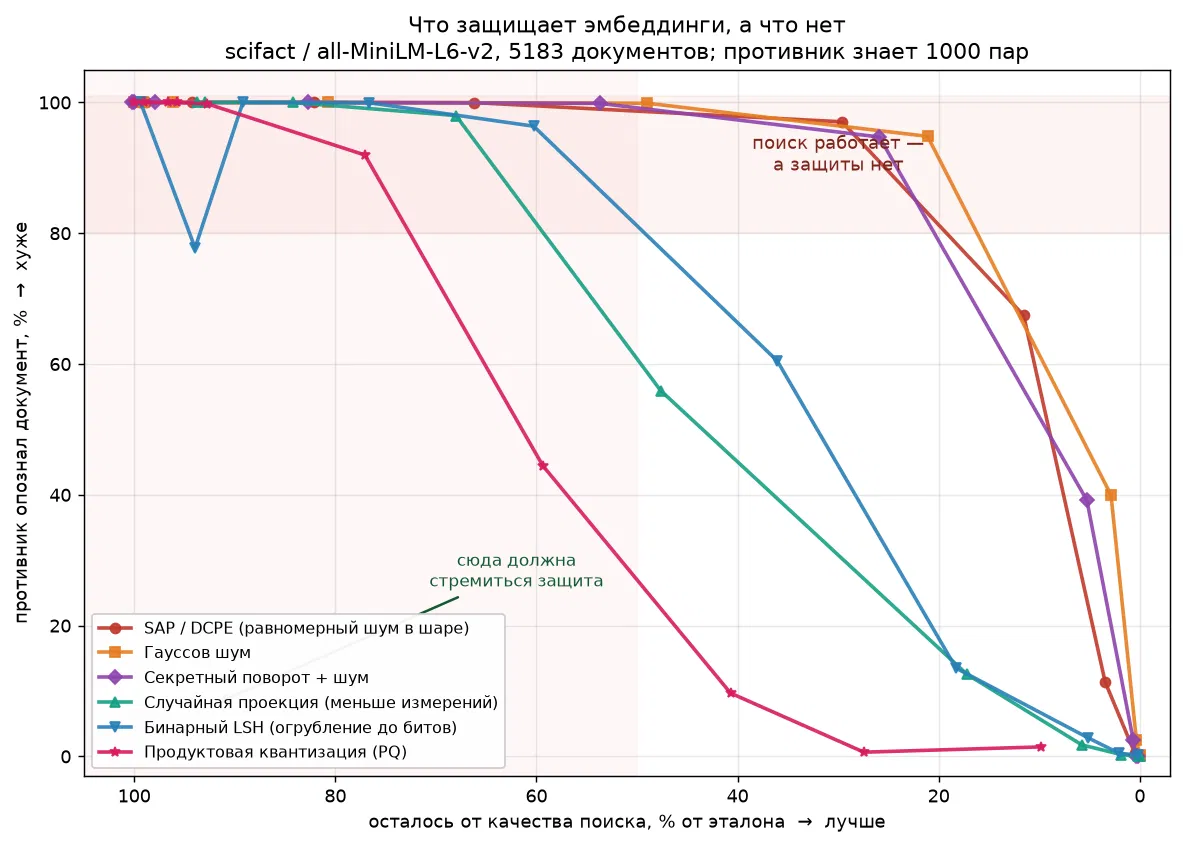
Шум в эмбеддингах не защищает данные: проверил 8 схем, и при 100 известных парах узнаётся ~90% документов

Коротко. Если хранить эмбеддинги с добавленным шумом, текст по ним восстановить трудно, но это не значит, что данные защищены. Я измерил, можно ли по защищённой записи узнать, какому документу она принадлежит, если атакующий знает часть соответствий (для основного сравнения 1000 из 5183 документов, ~19%). Для шума узнаётся 99% записей, даже когда качество поиска упало вдвое. При 100 известных парах (2% корпуса) узнаётся около 90%.

Читать далее
  •  

Kimi K3 — открытая модель, которая обошла закрытых лидеров рынка

Открытые системы редко конкурируют на равных с закрытыми лидерами индустрии: у их разработчиков обычно меньше вычислительных ресурсов и данных, чем у крупных лабораторий, и это сказывается на качестве. Kimi K3 — исключение: ее веса можно скачать и развернуть у себя, а на части независимых бенчмарков она обходит закрытые решения GPT и Anthropic. В этой статье я разбираю недавно опубликованный разработчиками официальный отчет, чтобы понять, что стоит за такими результатами.

Читать далее
  •  

Когда LLM должна сказать «Я не знаю»?

В RAG недостаточно найти документы на нужную тему: они должны содержать сведения, из которых можно обосновать ответ. Разберём три способа исследовать эту границу — от внешнего оценщика контекста до анализа активаций модели и испытаний на противоречивых свидетельствах.

Читать далее
  •  

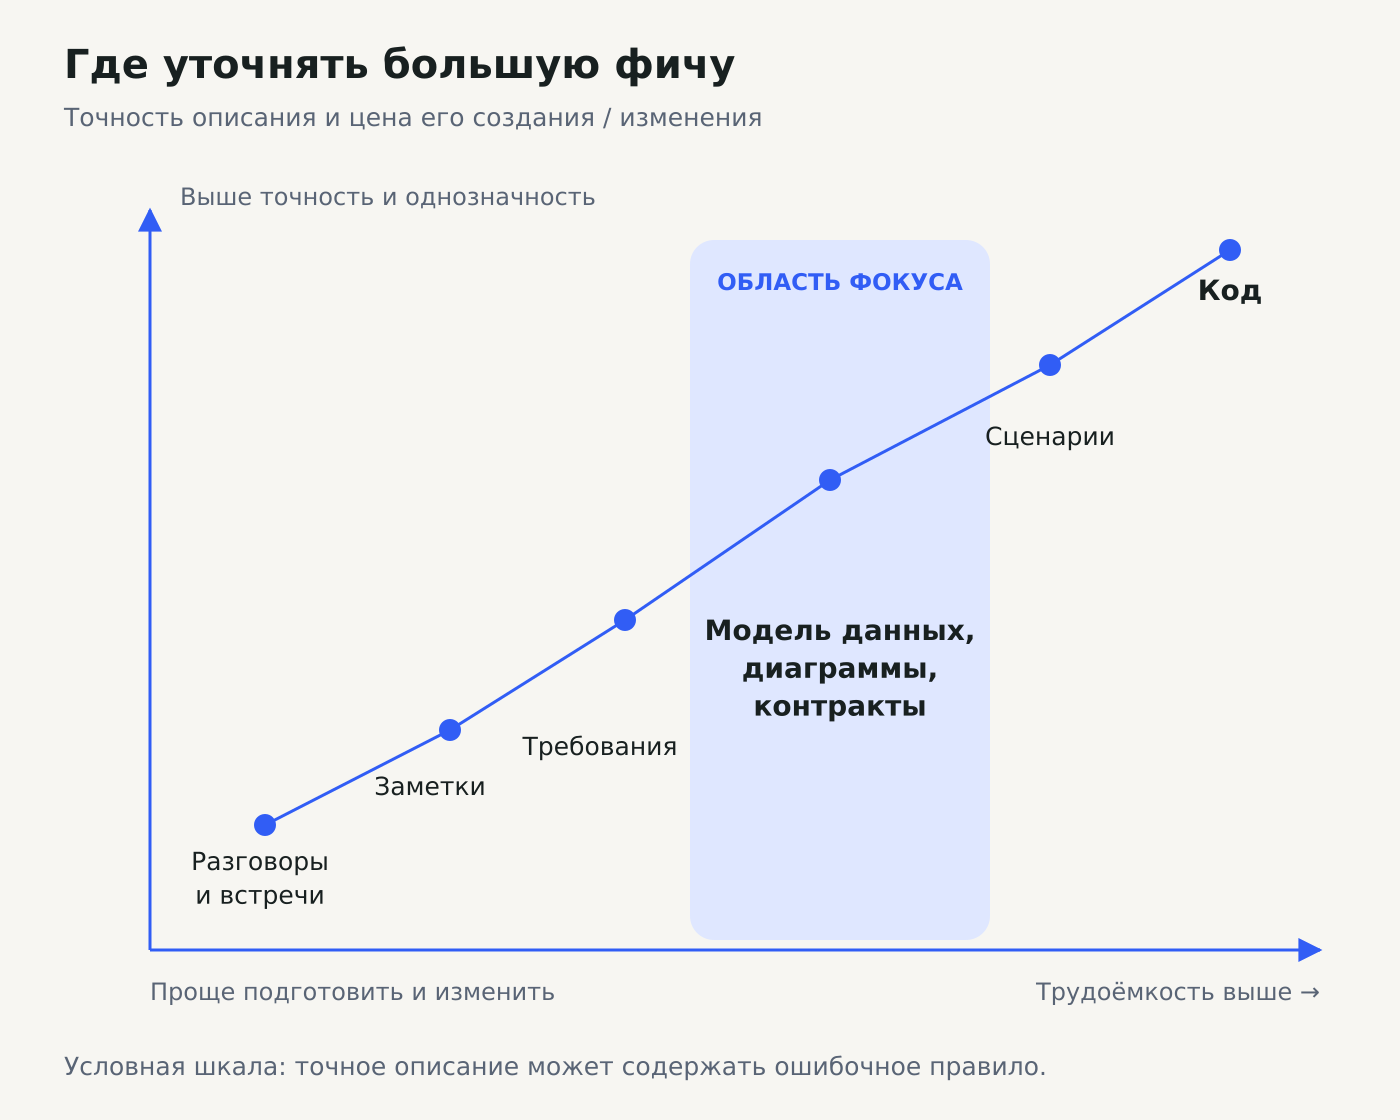
Большая фича без бесконечных переделок: Spec driven development с AI, UML, C4 и OpenAPI

Разработка большой фичи с нуля часто начинается обманчиво легко. Заказчик объяснил идею, команда обсудила экраны, разработчики примерно представляют архитектуру. Можно приступать. Но стоит перейти от общего замысла к конкретному поведению, как появляются вопросы, на которые у каждого участника свой ответ.

Возьмём веб-систему бронирования общего оборудования. Сотрудник выбирает проектор и время, подтверждает бронь, при необходимости отменяет её. Звучит как несколько форм и CRUD. Иллюзия простоты исчезает, когда два человека одновременно бронируют один проектор, временный резерв зависает навсегда, а отменённая заявка продолжает занимать время в календаре.

Разберём, как пройти путь от такой идеи до реализации через LLM: сначала сделать правила видимыми, затем согласовать модель и контракты, после этого передавать агенту небольшие задачи. Это учебный пример, а не отчёт о внедрении или обещание определённого ускорения.

Читать далее
  •  

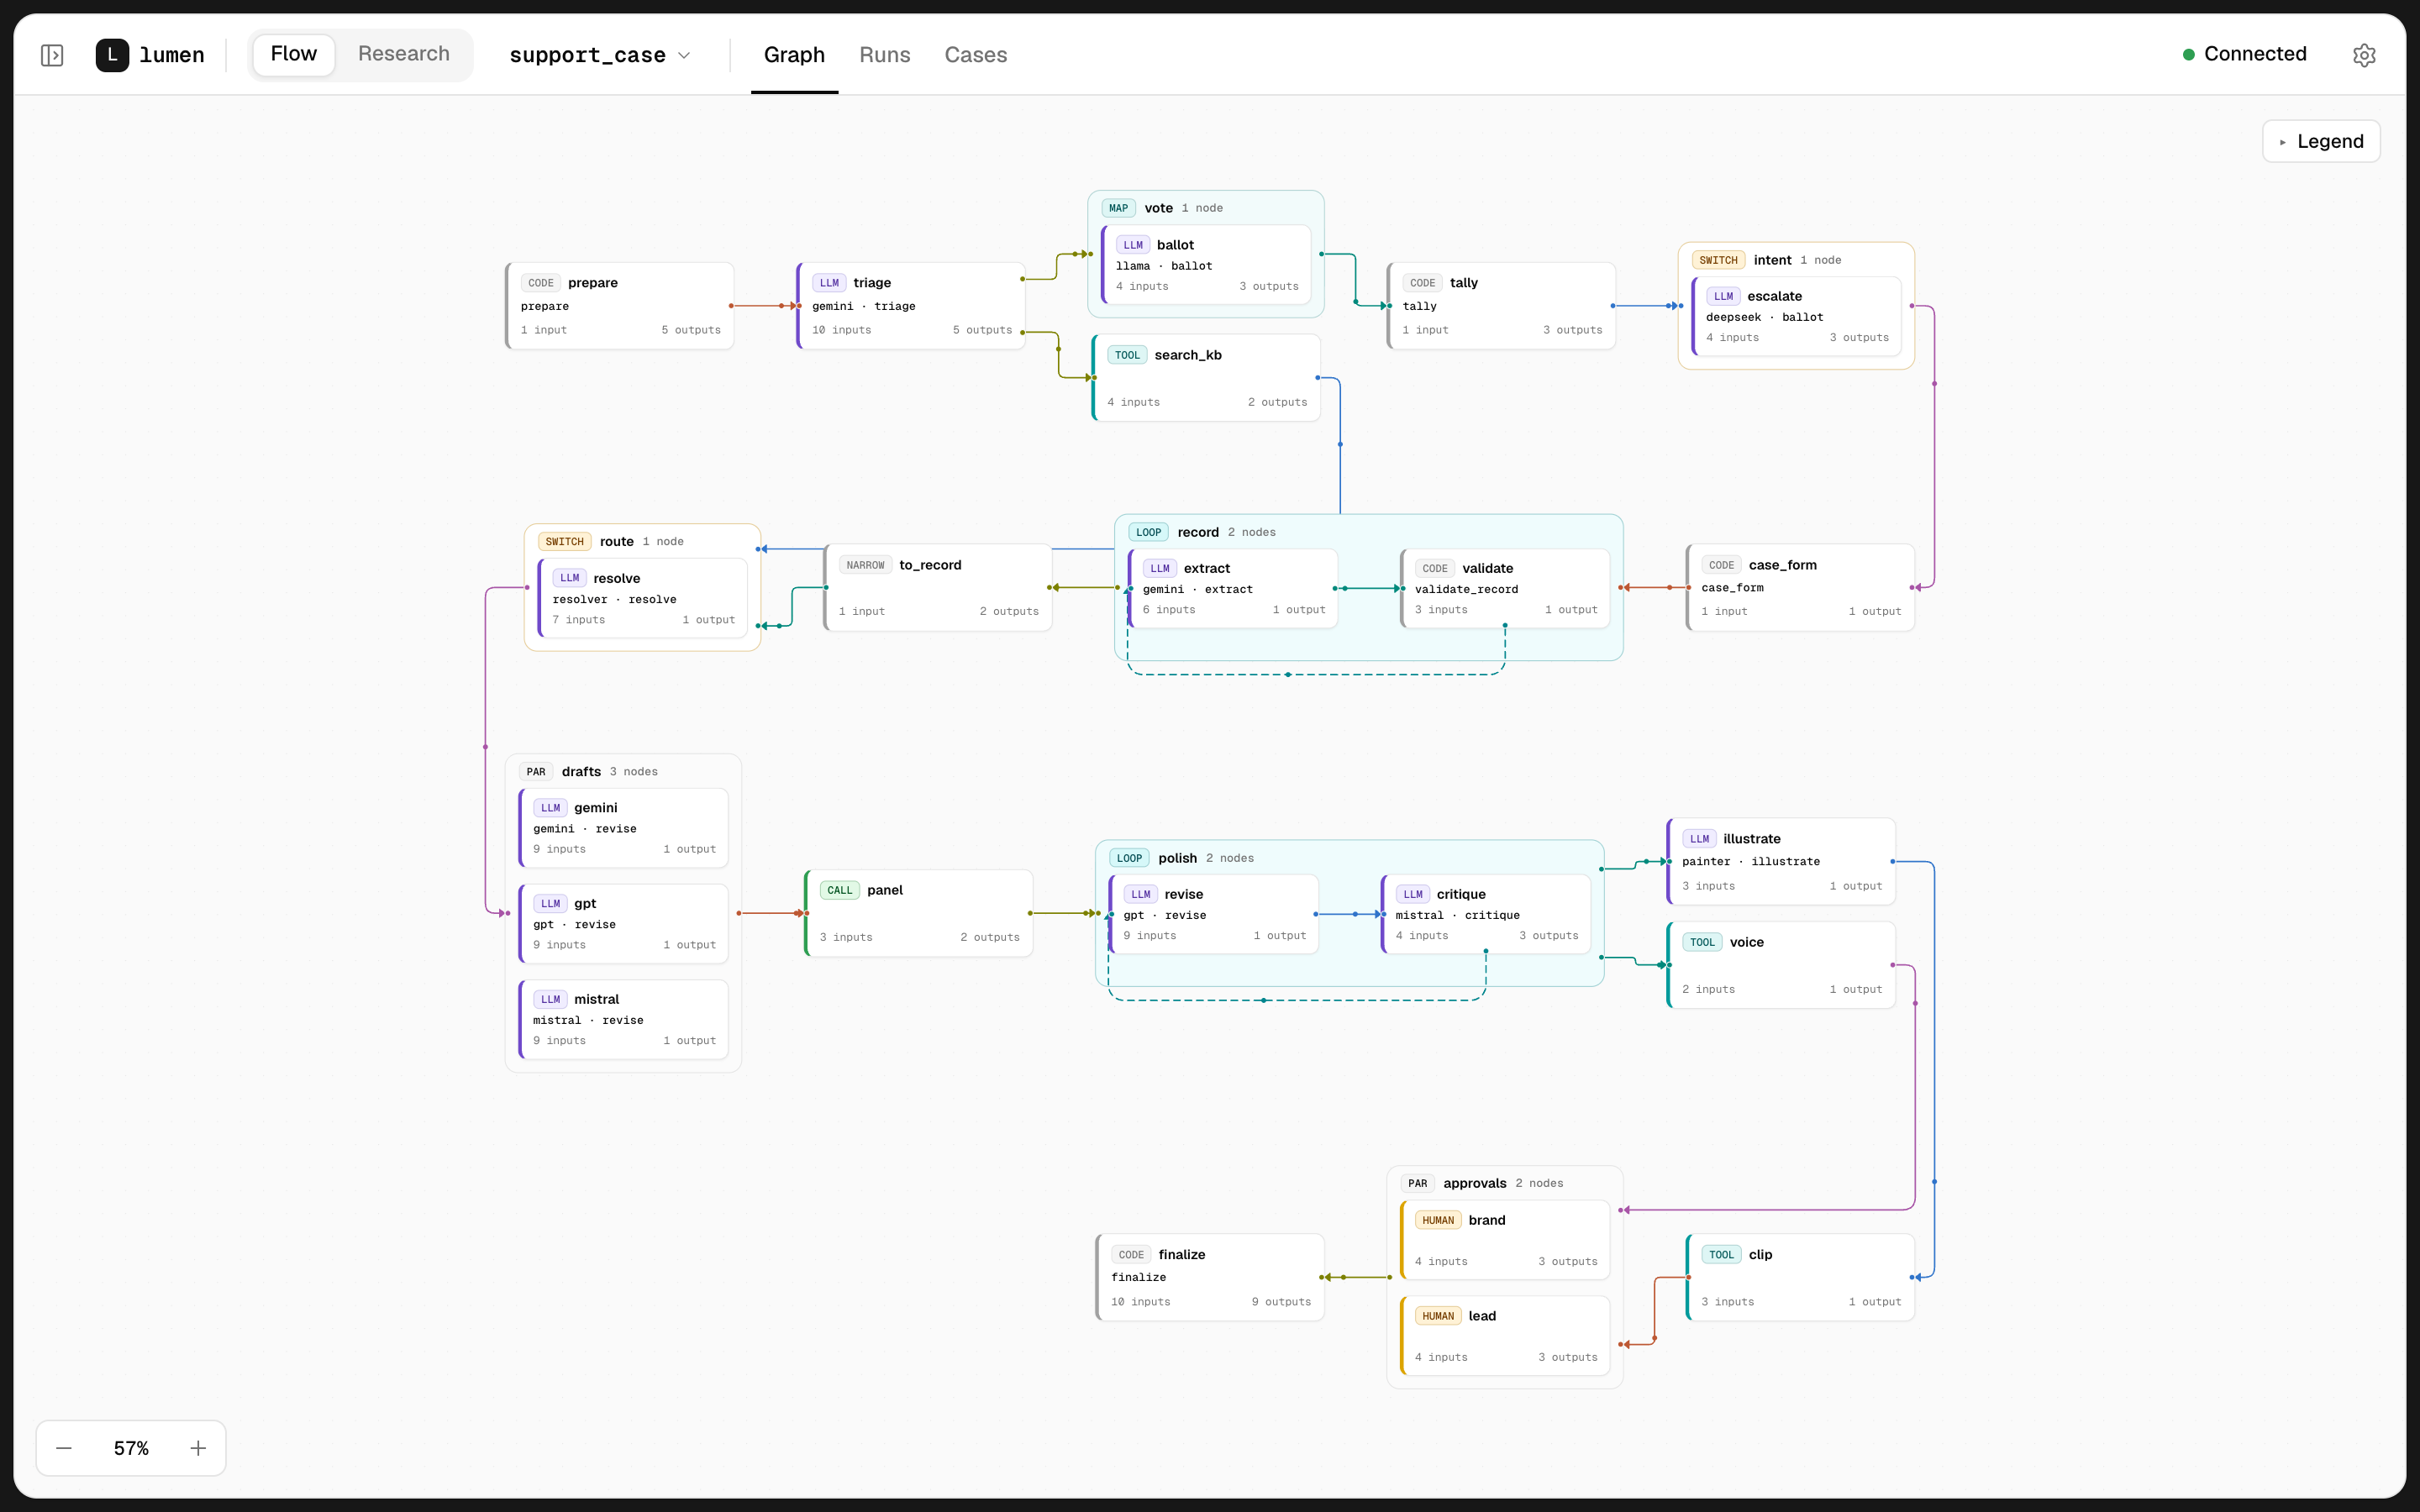
Workflow as a YAML: детерминированная песочница для агента поверх Pydantic AI

Агент уже пишет код за нас, но с автоматизацией для бизнеса всё иначе: он косячит на каждом шаге, в JSON-трейсе тысячи вызовов, а переписанный промпт вы даже не заметите. Я перестал перепроверять агента вручную — загнал его в жёсткие рамки: wrapper над Pydantic AI, MCP-инструменты, скиллы и Studio с отладчиком. Рассказываю, почему иначе нельзя, и показываю код.

Читать далее
  •  

Данные для языка, которого почти нет в интернете: текстовые слои, турецкие подмены и псевдоразметка двумя моделями

В первой статье серии я писал, что у крымскотатарского не было ни одного датасета, пригодного для серьёзной работы, и что начинал я с существующего речевого набора, который пришлось чистить. Во второй распознавалка научилась слышать нашу речь, в третьей синтезированный голос прочитал целый роман. Отсюда вопрос, который мне задавали чаще всего: если данных нет, на чём всё это училось?

Эта статья про данные. Оговорка та же, что и раньше, только строже: я не называю источники, архивы, издания, каналы, людей и организации, которые нам что-то передали, и не рассказываю о договорённостях с ними. Нет здесь и названий моделей, порогов фильтров и внутренних скриптов. Объёмы даю порядками величин. Зато будут метрики, методика проверки и грабли, на которые я наступил, и все цифры взяты из отчётов экспериментов, а не по памяти.

Читать далее
  •  

Периодические функции как функции активации в нейросетях

В данной статье мы рассмотрим применение периодических функций в качестве функций активации в нейросетях. Мы проведём сравнительные эксперименты на простых сетях и посмотрим, как периодические активации (например, sin) ведут себя по сравнению с классическими непериодическими — tanh, sigmoid и ReLU.

Читать далее
  •  

Я подсвечивал нейроны крохотного ИИ, чтобы понять, когда тот врет

В 2023 году адвокат из Нью-Йорка принес в суд записку со ссылками на прецеденты, которые ему «добросовестно» подобрал ChatGPT. Судья не нашел ни одного из этих дел. И не случайно: дел, на которые ссылался ИИ, не существовало вовсе. А через год Air Canada проиграла спор с пассажиром, которому чат-бот авиакомпании пообещал возврат денег по правилу, которое придумал ее же бот. Языковые модели ошибаются вполне уверенно, и по тексту ответа невозможно понять, путается ли модель искренне или привирает, прекрасно зная правильный ответ. Для людей эту задачу давно пытаются решать полиграфом, но он измеряет пульс и дыхание, то есть пытается замерить волнение, а с враньем оно связано очень косвенно.

Но у нейросети есть одно преимущество для исследователей: в отличие от человека, ее внутренности можно читать целиком. Буквально каждый нейрон. И все это без манжеты на руке и проводов на пальцах. Я решил проверить, получится ли собрать такой полиграф для языковой модели на домашней видеокарте. 

Первый же результат оказался интереснее, чем я рассчитывал изначально. Я попросил локальную модель соврать про цвет банана, и она уверенно ответила «Red», хотя на 25-м слое из 28 еще на 46% собиралась сказать «yellow». То есть правильный ответ у нее внутри был, а переписали его только последние слои. Но обо всем по порядку.

Читать далее

  •  

На каком языке ИИ-агенту искать по своей памяти: SQL или SPARQL?

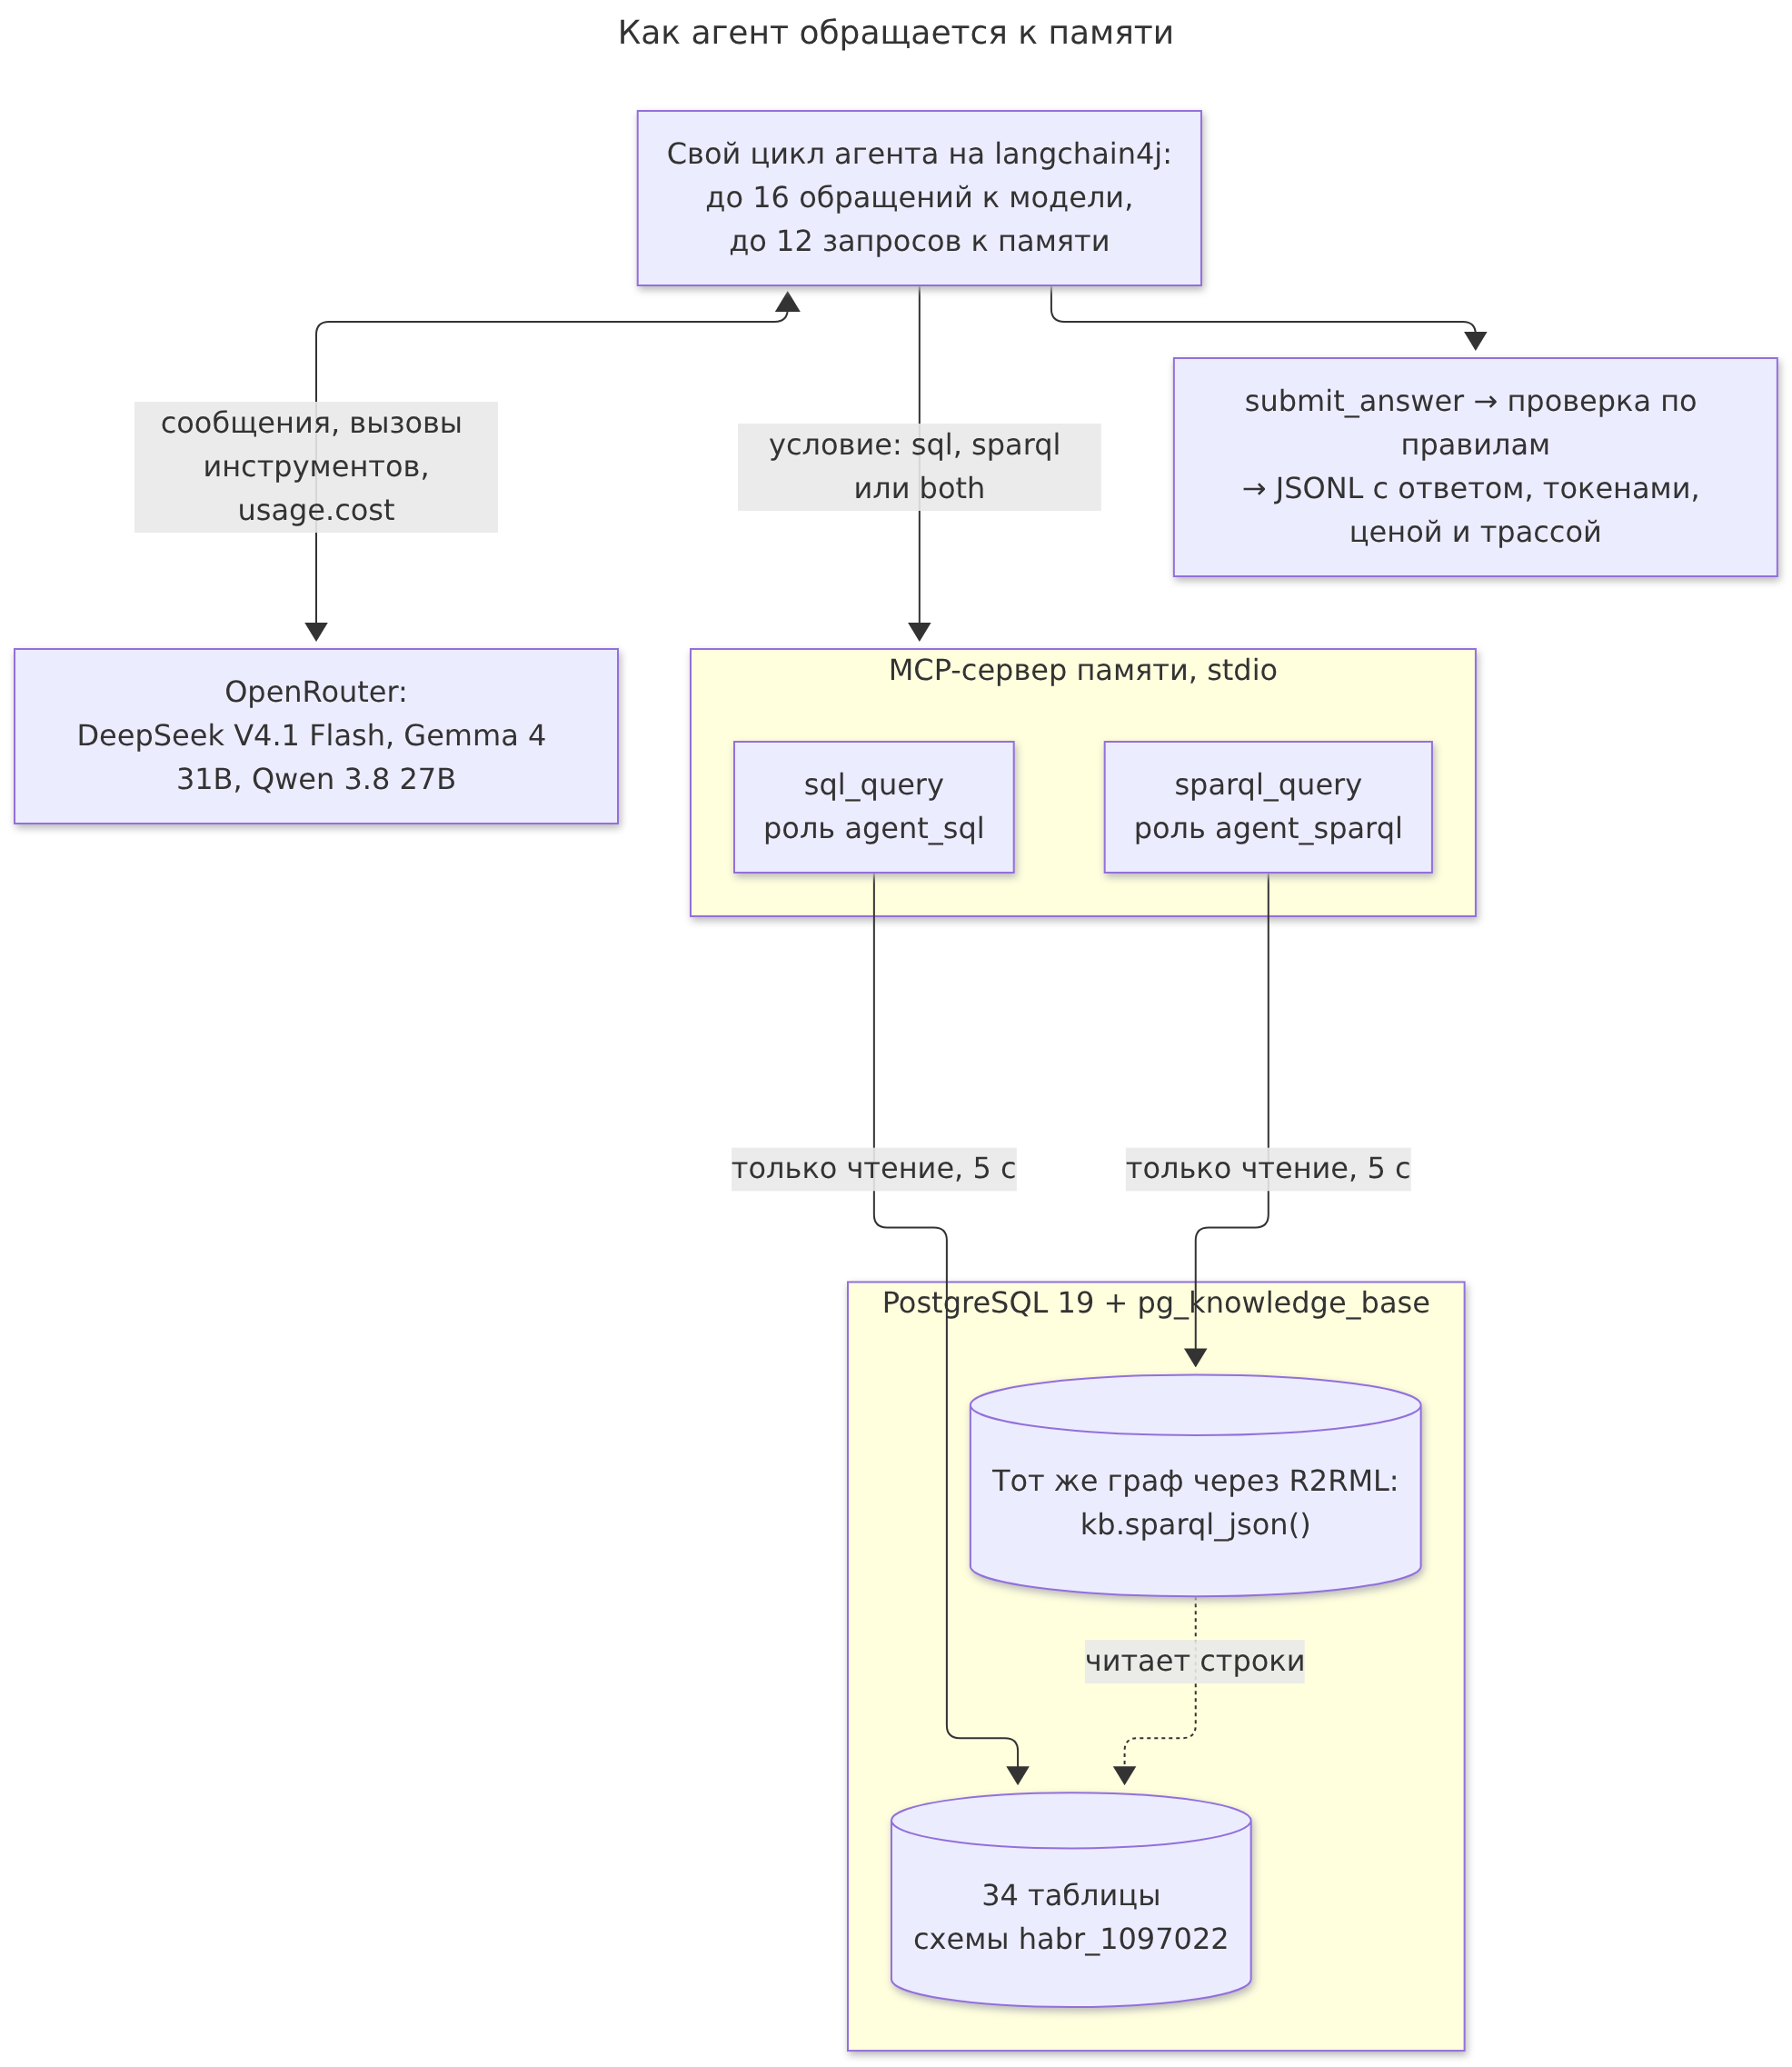
Память агентов в тренде с того момента как они появились, чтобы бороться с галюцинациями и давать ответы и решения LLM на собственной информации. Как лучше запрашивать информацию из таблиц или из графа часто решается на вере, начитавшись постов в интернет без своих экспериментов и измерений. В исследовании Sequeda и соавторов GPT-4 отвечал на вопросы по корпоративной SQL базе верно в 16% случаев, а по графу знаний поверх этой же базы в 54%, где у графа была онтология с описанием, а у SQL схемы только DDL типы и названия таблиц/колонок.

В моем GraphRAG одна и та же информация представлена в двух разных формах. Данные из статьи “Мой PostgreSQL быстрее твоего и почти догнал ClickHouse” извлек в 34 таблицы PostgreSQL, а в граф это превратил с помощью отображения R2RML. Подключил обе формы представления знаний к агенту по MCP и задал ему 15 вопросов о статье: через SQL, через SPARQL и дал еще выбор агенту из двух этих видов сразу. В моем эксперименте агент по очереди запускался на трех LLM с открытыми весами. Их можно развернуть на своей инфраструктуре или ноутбуке и данные и вопросы не уйдут провайдеру в логи или агрегатору между вами и LLM.

Таже я проверил и рассчитал что лучше для векторного хранения и семантического поиска: lance или pgvector. Поделюсь своими измерениями на современных моделях как лучше искать и в чем хранить знания.

Обнаружил в эксперименте как DeepSeek придумал SQL-инъекцию чтобы ответить на мой вопрос.

Читать далее
  •  

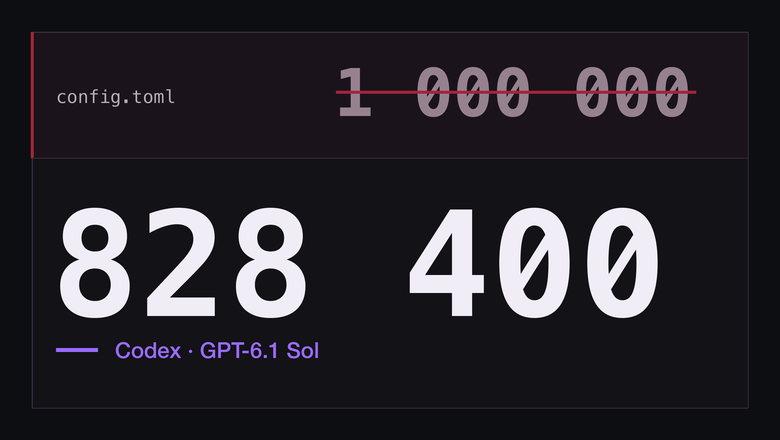
Миллион в config.toml, 828 тысяч в Codex и 890 тысяч на входе: что на самом деле значит окно контекста

В ~/.codex/config.toml у меня стоит model_context_window = 1000000. Codex на GPT-6.1 Sol в каждой задаче сообщает окно 828 400.

Я разобрал, откуда берётся это число, поднял его до 900 000 своим каталогом моделей и прогнал синтетический вход на 890 547 токенов с контрольными метками.

Контрольный запуск показал больше основного: тот же вход на 888 330 токенов прошёл и без моей правки, при окне 828 400.

Замеры сделаны 27.10.2026 на Codex CLI 0.163.0, вход через подписку ChatGPT. Часть данных - из сентябрьских проб на GPT-6 Astra, это помечено.

Читать далее
  •  

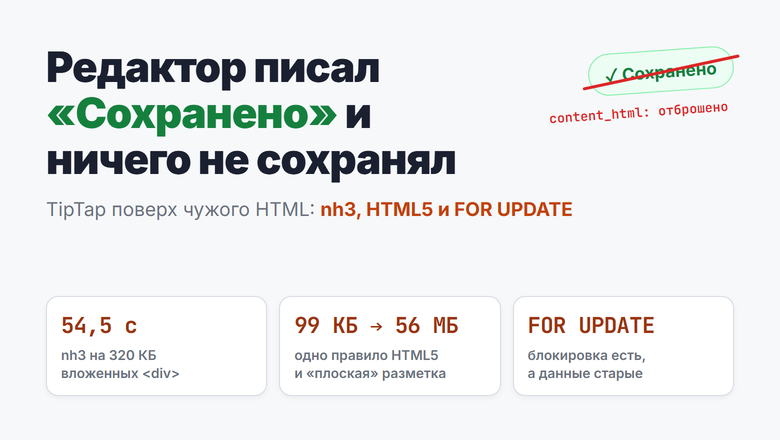
Редактор писал «Сохранено» и ничего не сохранял: TipTap поверх чужого HTML

Я делаю сервис, который пишет статьи и сам публикует их на сайты клиентов. Как устроена публикация в четыре CMS, я уже рассказывал здесь. Сегодня про соседний кусок: редактор в личном кабинете, где человек правит статью перед публикацией.

Как минимум два месяца этот редактор показывал «Сохранено» и не сохранял ни символа. Сама ошибка глупая, на неё хватит одного абзаца. Хуже, что очевидное исправление уничтожило бы статьи. По дороге к правильному нашлись ещё три ловушки. Санитайзер nh3 тратит почти минуту на 320 КБ разметки. Одно правило HTML5 превращает 99 КБ входа в 56 МБ выхода. А SELECT … FOR UPDATE в SQLAlchemy берёт блокировку и при этом отдаёт старые данные.

Читать далее
  •  
❌