❌

Reading view

Самообучение одноклеточных и коллективный интеллект
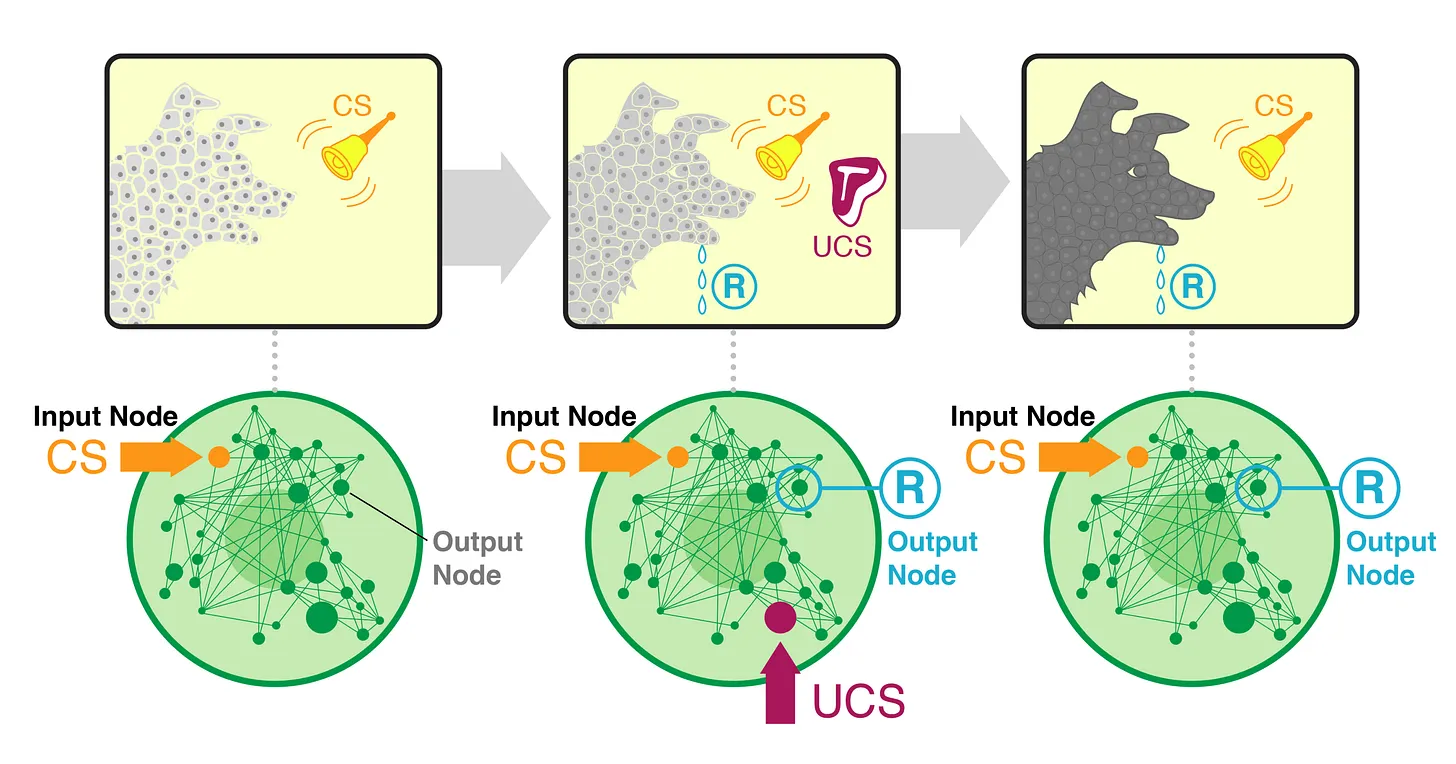
Казалось бы, обучение — это процесс, непосредственно связанный с нервной деятельностью. Неслучайно вычислительная единица в составе перцептрона и самообучающихся сетей названа именно «нейроном». Двухчастную работу «Нейронные сети для начинающих» о том, в каких отношениях искусственные нейроны напоминают естественные, написал на Хабре в 2016 и 2017 годах уважаемый @Arnis71 (свыше миллиона семисот двадцати тысяч просмотров у первой части — наверное, не рекорд Хабра, но полюбуйтесь, сколько закладок). Однако обучение, усваивание — это функция, которую у человека могут выполнять не только нейроны, но и, например, астроциты. Об этих удивительных клетках мозга я ранее рассказывал на Хабре в статье «Звёзды у нас в голове. О роли астроцитов в работе нейронных сетей». Сегодня хочу затронуть ещё более удивительную тему — механизмы обучения у одноклеточных.

Читать далее
  •  

HuggingFace для начинающих: как выбрать и запустить модель

Если вы интересуетесь темой ИИ и данных, то наверняка встречались с таким сервисом как HuggingFace - платформы и сообщества для разработчиков в сфере ИИ, этаким GitHub для ИИ. Она предоставляет централизованный и удобный хаб для обмена, поиска и совместной работы над открытыми моделями машинного обучения, наборами данных и приложениями.

Но она, мягко говоря, не самая удобная для пользователей, сразу понять как работать с сложным интерфейсом бывает сложно. Видишь 800 тысяч моделей, и чувствуешь примерно то же, что человек, который попал впервые на московский оптовый рынок в 1990е - все есть, ничего не понять, все смотрят тебя как на добычу, а с чего начать - нигде не написано. Через двадцать минут ты либо скачал не те датасеты, либо забросил это гиблое дело.

Проблема даже не в том, что HuggingFace сложный, тут больше нюанс что он требует уже понимать и знать платформу. Эта статья - легкий туториал по тому, как пользоваться HuggingFace, и как можно работать с данными и весами на нем, не заблудившись в трех соснах.

Читать далее
  •  

Архитектура VFS, часть 1 — файловая система и дескрипторы

Думаю, многие из нас, желавших освоить DevOps или углубиться в азы архитектуры всеми любимого Linux сталкивались с такими понятиями как Inode, файловые дескрипторы, виртуальная файловая система, какие-то там суперблоки и многое-многое другое.

Всё это, как я считаю, можно объединить двумя словами: "Архитектура VFS", которую мы сегодня и разберём. Перед тем как начать, я думаю, что нам стоит определиться, что КОНКРЕТНО мы будем изучать:

1. Что такое файловые системы, какими они бывают и зачем они нужны.

2. Что такое VFS, зачем она нужна и как она работает.

3. Что такое файловые дескрипторы (FD), зачем они нужны и как они работают.

4. Операторы перенаправления потоков.

Если вы, как и я, метите в DevOps(а именно для них эта статья и написана), то эта информация вам может понадобиться, как минимум, для того, чтобы пройти собеседование - на тему траблшутинга часто могут задавать вопросы в духе "удалил файл, но процесс всё равно продолжает его читать".

Читать далее
  •  

Вайбучение

Давайте сразу. Вайбучение — это когда нет паузы между получением и применением знаний. Система подготовки к жизни без вертикальной передачи знаний, базирующаяся на инициирующих событиях.

Это не «Образование 5.0» или какой ещё ярлык пытаются налепить на попытку его реанимировать. Нам не нужно каким-то образом сделать образование лучше. Нам нужно отказаться от него полностью. И если вы хоть как-то с ним связаны, то это самый полезный текст, который можете сейчас прочитать.

Читать далее
  •  

Объединяй и властвуй: как перенести ML-эксперимент из лабораторного кластера в промышленный за 60 секунд

Всем привет! Мы команда ML-платформы Ozon. Мы строим инфраструктуру, которой ежедневно пользуются дата-сайентисты и ML-инженеры — от первых экспериментов в Jupyter до обучения моделей на больших GPU-кластерах. Наша задача заключается в предоставлении доступа к современным вычислительным технологиям через привычные инструменты и единый интерфейс платформы. 

Со стороны может показаться, что формула счастья наших пользователей предельно проста: «GPU для всех, даром, и пусть никто не уйдёт обиженным». В реальности всё, конечно же, сложнее. Вычислительные ресурсы должны использоваться эффективно. При этом разные этапы рабочего процесса требуют разного оборудования и инструментов. Поэтому выполнять весь процесс на одном, пусть и сверхмощном, кластере не всегда рационально. Если же распределить этапы между несколькими кластерами, нужно обеспечить их взаимодействие, чтобы рабочий процесс выполнялся бесшовно.

Значит, нам необходим механизм, обеспечивающий эту связь. Решение, позволяющее взять пользовательский эксперимент, собрать его код и зависимости в одном кластере и воспроизвести в другом, — чтоб переход между стадиями рабочего процесса происходил в одно действие, быстро и удобно для пользователя. Как мы решили эту задачу и какие выводы сделали — в этой статье.

Читать далее
  •  

Как построить self‑hosted RAG‑систему с LangGraph‑агентом на локальных LLM

Обычно стек для RAG‑систем и AI‑агентов строится вокруг облачных API (OpenAI, Anthropic) и управляемых векторных баз. Но для ряда задач критически важна полная автономность: устойчивость к санкциям и независимость от внешних провайдеров.

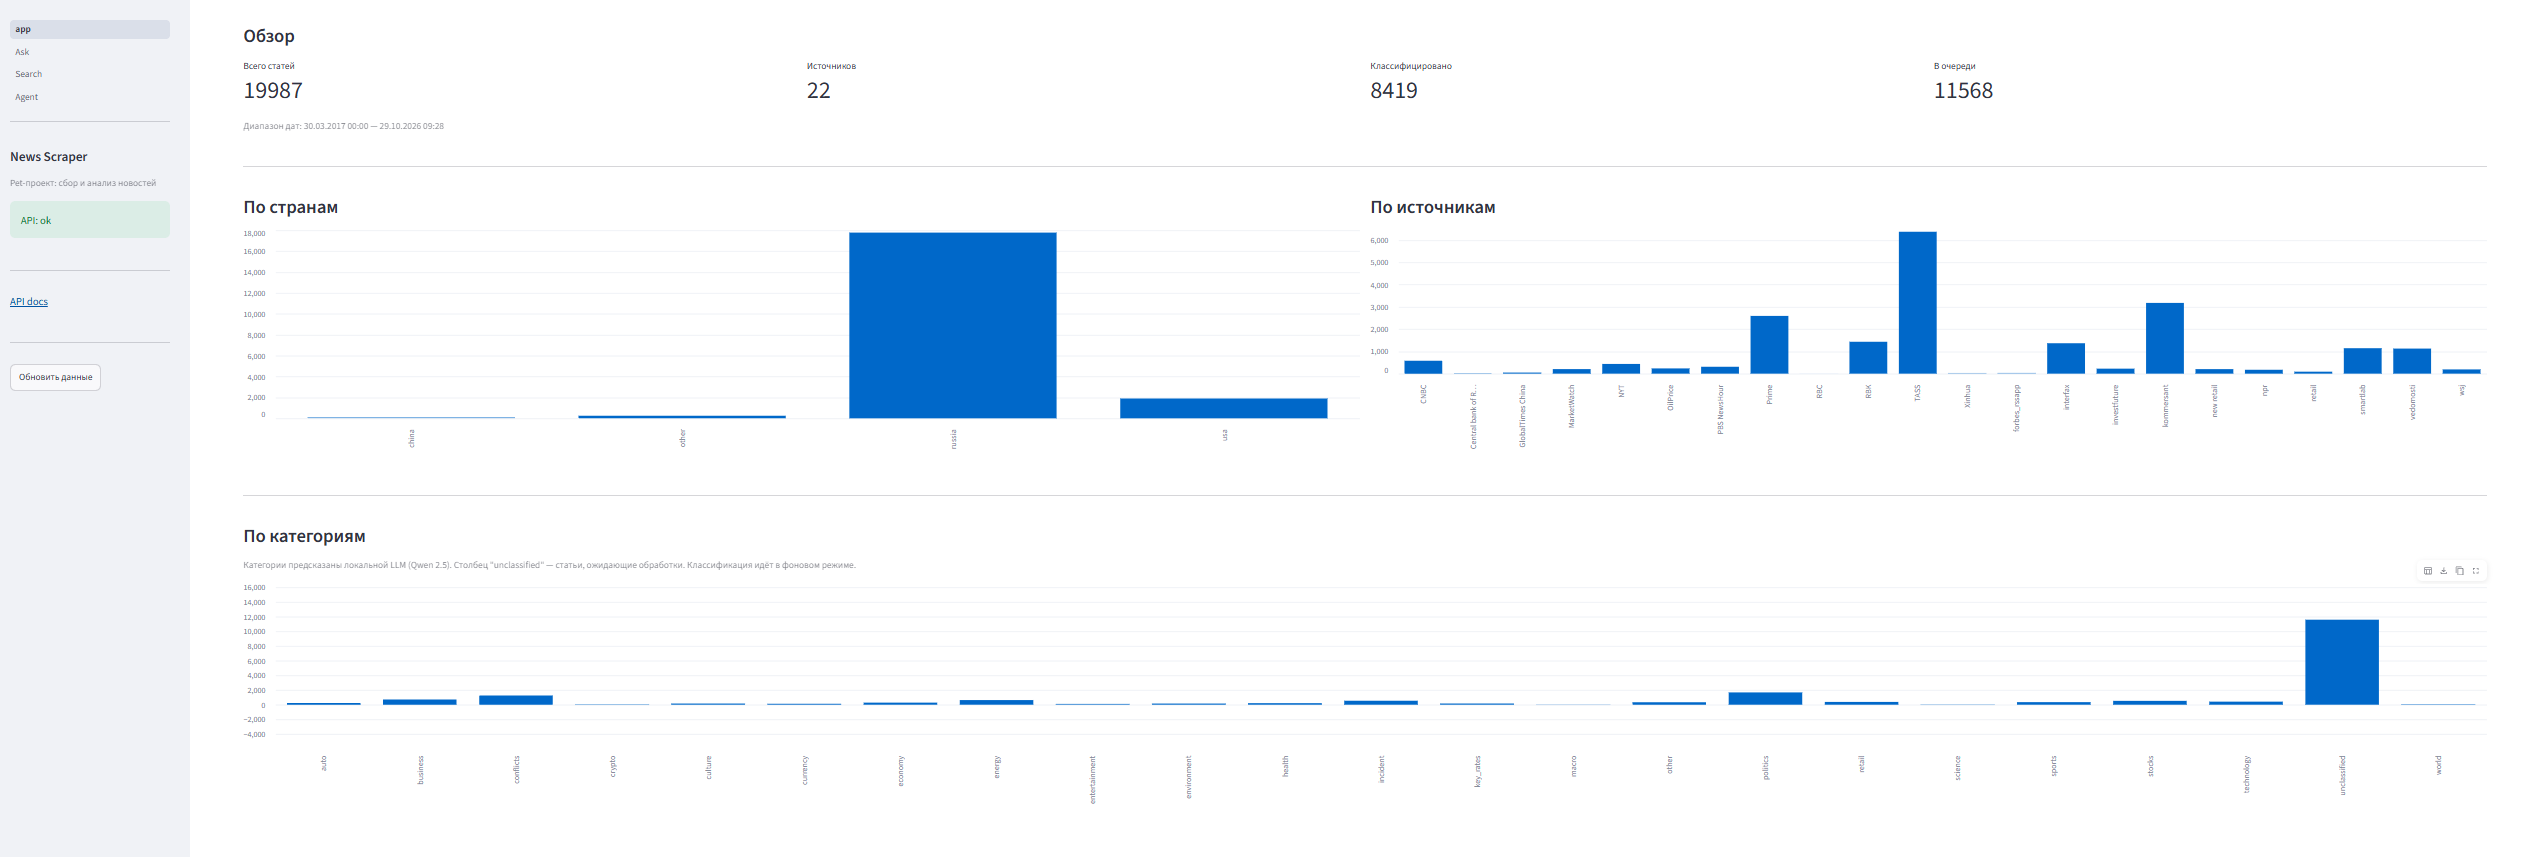
В этой статье я расскажу, как спроектировал и собрал аналитическую систему, которая за две недели работы агрегировала более 12 000 новостей: от сбора RSS‑лент до умного агента, который сам вызывает инструменты. Мы пройдем путь от архитектуры до граблей, на которые я наступил.

Стек: Python 3.12, FastAPI, PostgreSQL + pgvector, Celery, LangGraph, Ollama (Qwen 2.5 14B, BGE‑M3), Streamlit, Langfuse, Docker.

Читать далее
  •  

Позиционные эмбеддинги, или Почему 3 + 5 не всегда 8

Меня зовут Настя, я Data Scientist и TeamLead. Сегодня хочу рассказать про вредную занозу, которая засела у меня в голове и далее я не могла это игнорировать.

Сейчас я читаю книгу Себастьяна Рашки «Строим LLM с нуля». Читаю по-взрослому: глава за главой, с открытым Jupyter рядом и кружкой кофе (не первой). И на разделе 2.8 про позиционные эмбеддинги я встала. Прямо как вкопанная.

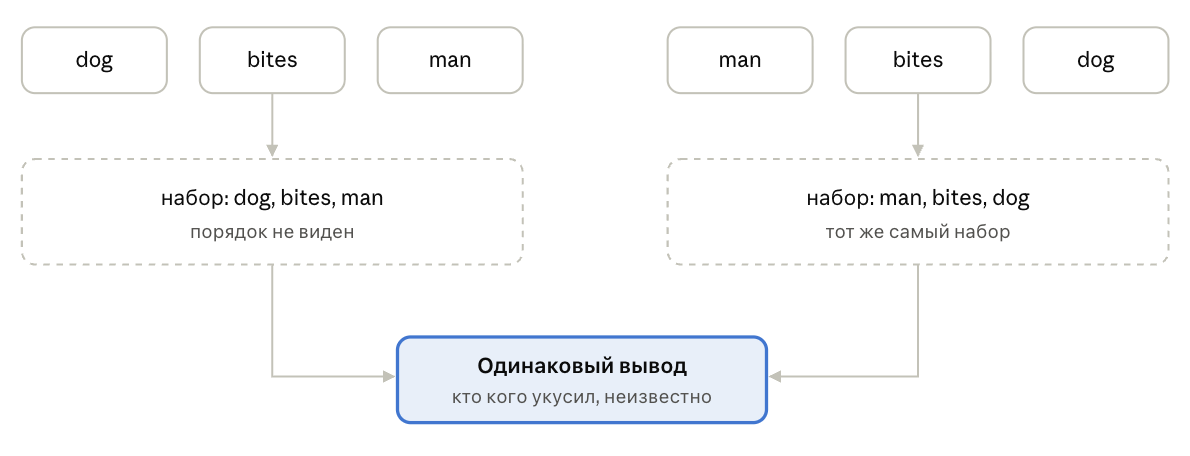
Причём там не сложно! В книге это буквально три строчки кода: есть таблица эмбеддингов слов, есть таблица эмбеддингов позиций, складываем — и вперёд, к attention. В других учебниках и статьях то же самое: «просто прибавим вектор позиции той же размерности». Ну понятно же? Понятно. Только в голове вместо ясности почему-то остался список вопросов:

Изнать подробности
  •  

Бесплатный аналог Auto Label от Roboflow: как я разметил 12 576 кадров за ночь

Под диплом мне нужен был датасет по средствам индивидуальной защиты. Шесть классов, и хуже всех в открытых наборах представлена сварочная маска: после удаления дублей около двух тысяч кадров. Я нарезал видео, получил в пять-шесть раз больше кадров, чем попало в итог, и упёрся в разметку.

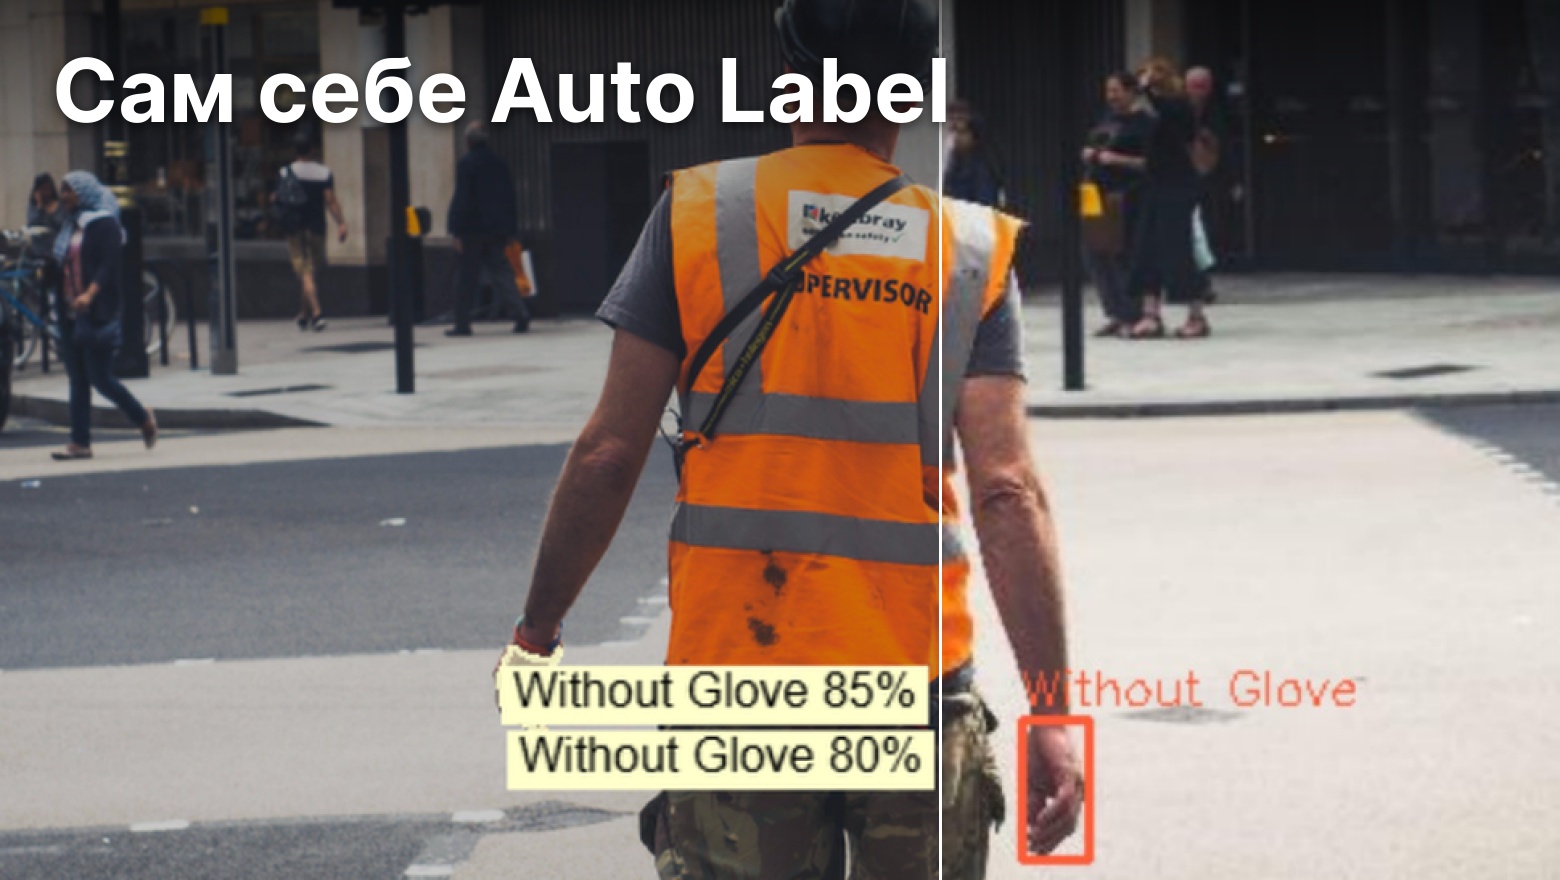
Auto Label у Roboflow задачу решал, но на бесплатном тарифе это полгода ожидания, а платный прогон по всему массиву обошёлся бы примерно в двести долларов. Поэтому я написал автоаннотатор на SAM3: пятнадцать файлов на PyQt6, текстовые промпты вместо обучения, пороги по классам.

Главный трюк — конфликты классов. SAM3 находит «руку» и «перчатку», а нарушение приходится вычислять вычитанием: если бокс руки перекрыт перчаткой больше чем на четверть, он уходит в нарушение. На этом держится вся разметка шести классов.

Итог: 12 576 кадров, 104 726 боксов, одна ночь на RTX 4060 Ti, ноль рублей. Модель на датасете даёт mAP50 = 0.825. В статье есть код и разбор того, где SAM3 врёт.

Читать далее
  •  

Монетка, толпа и трансформер: что на самом деле делает квант-исследователь на примере 9 лет данных криптовалюты ADA

Когда говоришь «я анализирую данные бирж»/Quantitative Analyst, собеседник представляет нейросеть, которая видит будущее, и ключи от спорткара. Реальность скромнее: квант-исследователь большую часть времени ловит за руку самого себя.

Это разбор одного большого исследования данных криптовалюты только для одной валюты ADA: 9 лет минутной истории, стаканы с 16 бирж, своя нода блокчейна и около 3 000 гипотез. Мы переведём график цены в «текст» и скормим его трансформеру, устроим эволюцию формул, проверим RSI, уровни Фибоначчи, Луну и ретроградный Меркурий, попадём в три статистические ловушки, которые рисуют сигнал из ничего, и выберемся из них.

Внутри: почему модель, угадывающая 92 % случаев, теряет 80 % денег в год; почему лучшая из миллиона формул всегда выглядит гениальной; откуда у топ-копитрейдеров ×60 за год и чем они отличаются от монетки с плечом. А ещё — восемь признаков, которые честно знают о рынке больше самой цены, и чек-лист, как не обмануть себя на данных.

Спойлер: Грааль не найден. Зато найдено кое-что поинтереснее — понимание, где его точно нет.

Читать далее
  •  

Я дообучил маленькую нейросеть на MacBook, и она стала хуже. Честные цифры

В прошлой статье я пообещал дообучить самую маленькую модель своего лаунчера Lumi прямо на MacBook и показать, что выйдет, «даже если станет хуже». Как в воду глядел. После 328 примеров и LoRA через MLX модель решила, что 2 + 2 × 2 = 4, а «скуф» — это лодка, и набрала на запечатанном экзамене 4 из 23 вместо 6. Со второй попытки я вернул её к исходным 6. Рассказываю, что пошло не так, почему маленькой модели мало нескольких сотен примеров и почему обученную модель пока нельзя перенести в Ollama.

Читать далее
  •  

Архитектура 1С для новичков: Строим первую внешнюю обработку и клиент-серверный мост. Часть первая

Боитесь запутаться в клиент-серверной архитектуре и управляемых формах? В этой короткой статье разберем самый простой и понятный алгоритм создания внешней обработки с нуля. Идеально для начинающих разработчиков и студентов, делающих первые шаги в 1С.

​Каждый начинающий программист 1С рано или поздно приходит к моменту, когда типовых возможностей конфигурации не хватает, а вносить изменения в саму конфигурацию (снимать с поддержки) нельзя или не хочется. Именно для таких задач и существуют внешние обработки (файлы с расширением .epf),они не мешают последующим типовым обновлениям от фирмы 1С.

Шаг 1. Создаем файл обработки в Конфигураторе

Открываем Конфигуратор и идем по классическому пути: Файл — Новый — Внешняя обработка.

Перед нами пустая карточка. Здесь нас интересуют два поля: Имя и Синоним.

Имя — это то, как к вашей обработке будет обращаться сама система в коде (пишем строго без пробелов, например: ЗагрузкаДанныхИзФайлов).

Синоним — это название, которое 1С выведет на экран пользователю (тут пробелы и знаки препинания разрешены, например: Умный импорт первички).

Шаг 2. Проектируем интерфейс (Управляемую форму)

Находим в дереве пункт Формы, жмем на лупу и создаем новую управляемую форму обработки.

Добавляем данные: В правом верхнем углу (вкладка Реквизиты) нажимаем «Добавить». Нам нужна строка, назовем её ПутьКФайлу, перетаскиваем в левое верхнее окно Элементы. 

Лайфхак для интерфейса: Выделяем это поле, открываем его свойства (Alt + Enter) и в поле Заголовок пишем то, что должен увидеть пользователь, а чуть ниже находим свойство КнопкаВыбора и ставим галочку Да (чтобы в поле появились заветные три точки ...).

Читать далее
  •  

Линейное внимание может больше

Привет, Хабр! Мы — студенты мастерской по сервисам и платформам ИИ Инженерно-математической школы НИУ ВШЭ и VK: Павел Алексеев, Александр Рожкин, Андрей Аргаткин, Алексей Павлов и Матвей Каменев. В этом проекте мы проверяли, как повысить качество моделей с линейным вниманием до уровня обычного трансформера. Такой механизм позволяет обрабатывать длинные последовательности без квадратичного роста вычислительных затрат. Это делает его перспективным для более экономного обучения языковых моделей и обработки длинных документов. При авторегрессионной генерации текста он помогает экономить память: вместо растущего KV-cache можно хранить состояние фиксированного размера.

Отправной точкой стала архитектура Dense Attention. Она использует простые матричные операции без softmax, но в опубликованных экспериментах показывает высокое качество. Наш руководитель Андрей Аргаткин в статье о Dense Attention задал новое направление исследования. Мы разберёмся, какие компоненты модели обеспечивают этот результат и можно ли перенести их на другие варианты внимания.

Рабочая гипотеза — линейные модели отстают по качеству не только из-за замены softmax, но и из-за архитектурных настроек и обучения. Число голов, позиционное кодирование и схема слоёв, подобранные для стандартного трансформера, не обязательно оптимальны для линейного механизма. Мы проверяли, сократят ли разрыв по качеству изменение этих компонентов и MLM-предобучение, если не возвращаться к глобальному softmax-вниманию.

Читать далее
  •  

Дообучаем Gemma 26B на MacBook с 24 ГБ памяти: как устроен голосовой помощник, который работает без интернета

Полгода я собираю голосового помощника для macOS, который не просто отвечает, а выполняет действия на компьютере. Главное условие — языковая модель работает локально, без облака и подписок. Рассказываю, из чего состоит такая система, как я дообучал Gemma 26B на MacBook с 24 ГБ памяти и на какие грабли наступил по дороге.

Читать далее
  •  

Почему softmax теряет градиенты — и как школьная алгебра 7-го класса помогает их сохранить

Модель почти идеально выучила ответ, а градиент правильного класса уже стал машинным нулём. При дистилляции возможна обратная ситуация: ученик повторяет учителя, но вычисление всё ещё выдаёт сигнал ошибки. Разбираю исправления DeepMind на школьной алгебре, проверенных примерах NumPy и четырёх графиках: где теряются маленькие числа, как это влияет на обучение и что стоит проверить в своей среде.

В статье есть практические рекомендации, как понять, нужно ли это учесть в ваших программах и нейросетях, и если нужно — как исправить в своем коде ошибку из стандартных библиотек.

Самое удивительное тут то, что, казалось бы, подобная тема должна быть исследована вдоль и поперек еще на заре развития машинного обучения, а в реальности важнейший научный препринт от DeepMind об этом вышел 22 октября, то есть меньше недели назад.

Кроме того, рекомендую включать этот материал в базовые учебные курсы.

Читать далее
  •  

PyLab — 2 года: как пользователи превращают пет-проект в продукт

28 октября моему пет-проекту PyLab, приложению для изучения Python и написания кода прямо на смартфоне, исполнилось два года. В прошлой статье я рассказывал, что умеет приложение, а сегодня расскажу о решениях: почему горячие правки обходятся дороже, чем кажется, чем окупился полный редизайн в версии 4, как одна идея пользователя стала любимой функцией и почему модерация в сторах превращает каждую ошибку в проблему на неделю.

Читать далее
  •  

Под капотом iZotope: что общего у Nectar, Neutron, Ozone и RX

У iZotope есть плагины для вокала, сведения, мастеринга и реставрации записи. Снаружи они выглядят как отдельные продукты. Внутри обнаруживаются общие вычислительные узлы, интерфейсные механизмы и способы передачи параметров.

Я разобрал, как устроено это семейство: что связывает компрессоры Nectar и Neutron, зачем iZotope собственный интерфейсный движок Glass и где в обработке участвуют ML-модели. Отдельно проверил задержку компрессора Nectar: при 48 кГц сигнал сдвигается на 47 сэмплов даже при Mix 0%.

В статье покажу схемы, примеры C++ и результаты измерений. Заодно сравню эти решения с открытыми проектами и разберу, сколько работы скрывается за привычными ручками Attack, Release и Mix.

Читать далее
  •  
❌