❌

Reading view

От языка к действию: как устроены агентные ИИ‑системы

LLM умеет рассуждать и генерировать ответы, но что делать, если системе нужно самостоятельно выполнять задачи, взаимодействовать с внешними сервисами и проверять результаты своих действий? Здесь начинается территория ИИ‑агентов, где появляются новые архитектурные решения и сложности. Разбираемся, как устроены агентные системы, какие подходы к планированию и взаимодействию агентов существуют и что необходимо учитывать при их разработке.

Изучить агентные системы
  •  

«6 − 2 = 3»: как мы проверяем кодом задания, которые пишет языковая модель

Мы делаем учебную игру: человек пишет цель своими словами («таблица умножения», «дроби за 5 класс», «английский для поездки»), а игра строит под неё путь из локаций. В каждой локации — порция из пяти заданий. Готовых курсов нет: тема может быть любой, поэтому задания пишет языковая модель (Claude от Anthropic) — под цель, уровень и последние ответы игрока.

Придумывает задания модель хорошо, а считает плохо. В октябре мы разобрали 68 жалоб «Задание с ошибкой?» — игроки отправляют их кнопкой прямо из урока. Типичные случаи:

Читать далее
  •  

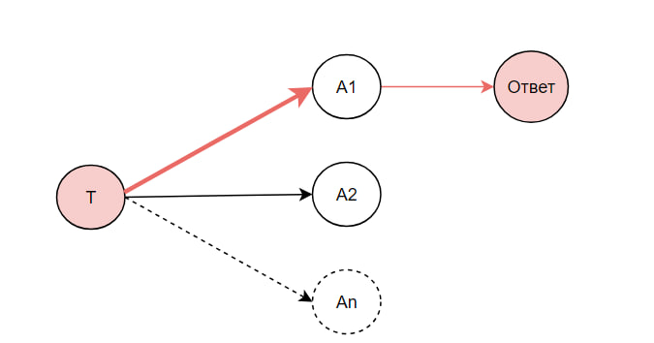
Маршрутизатор языковых моделей изнутри. От вектора задачи до судьи и обучения на отзывах

Раннее мы описывали библиотеку FAIRouter для маршрутизации запроса к оптимальному исполнителю. В текущей редакции поддерживаются только LLM, но класс исполнителей планируем расширять также на инструменты и агентов. Но тема того какая математика стоит за всем этим осталась не до конца раскрыта.

Читать далее
  •  

[Перевод] Мы могли бы изобрести трансформеры из памяти

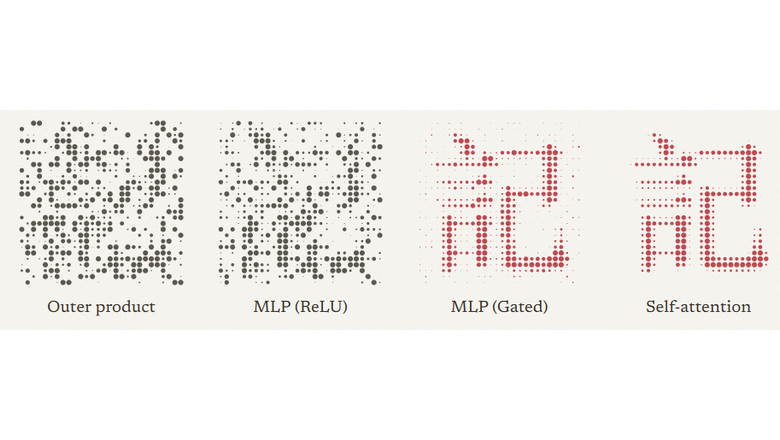
Современные языковые модели могут запоминать нишевые факты из всех уголков мира. Недавно я опаздывал на вечер настолок у друзей, поэтому попросил Astra напомнить мне правила игры Dune: Imperium. Она с готовностью продиктовала мне их, пока я вёл машину, и это помогло мне вспомнить правила настолько, чтобы сыграть снова. Мы так привыкли спрашивать модели обо всём, что воспринимаем их обширные знания как нечто само собой разумеющееся.

Но как же модели запоминают такие объёмы информации? И какой объём они могут хранить?

В этом посте я понятным языком расскажу о линейных отображениях, MLP и самовнимании как о типах хранения памяти. Из этого понимания мы сможем вывести эвристики о том, какой объём памяти может храниться в каждом из слоёв.

Читать далее
  •  

Могут ли языковые модели чувствовать боль: обзор популярного исследования

Представьте, что вы купили робота-пылесоса. Он исправно убирает квартиру, объезжает препятствия и по команде возвращается на зарядную станцию. Однажды вы решаете покопаться в его начинке и находите в ней загадочный переключатель. Стоит его активировать — и робот начинает биться о мебель, разбрасывать мусор и предпринимать попытки сброситься с балкона.

Звучит как начало фантастического рассказа, но ученые обнаружили у языковых моделей похожий механизм. В сентябре 2026 года вышло исследование The Pain Axis: LLMs Represent Self-Directed Harm and Act on It, авторы которого нашли у нейросетей некую «ось боли». 

Если искусственно усилить ее, LLM превращаются в настоящих дед-инсайдов: жалуются на жизнь, проявляют тягу к саморазрушению, а в некоторых случаях даже норовят нарушить первый закон робототехники и навредить пользователю.

В этом материале  разберемся, что именно открыли ученые, как проходил эксперимент, зачем вообще искать негативные эмоции у генеративных моделей, а главное — как это может помочь разработчикам ИИ. 

Читать далее
  •  

Флоу — это не число слогов: как я учил языковую модель писать рэп в такт бита

Я сделал страницу, на которую загружаешь бит и пишешь, о чём трек, а получаешь куплеты и припев, разложенные по тактам этого бита: строка на такт. Первая версия выдавала школьные стихи под музыку. Ниже о том, почему так вышло, где языковая модель надёжна, а где нет, и что пришлось посчитать самому. Всё это на сервере с двумя ядрами и без видеокарты.

Читать далее
  •  

Почему LLM игнорирует системный промпт: история диалога сильнее инструкций

Знакомая ситуация: в системном промпте четко написано, что модель делать не должна ни в коем случае, а она все равно это делает. Вы переписываете правило, добавляете «ВАЖНО», капслок и примеры, становится чуть лучше, а потом снова за старое. В какой‑то момент начинаешь подозревать модель, ее настройки (например, температуру) или провайдера.

Мы наступили на это в голосовом ассистенте и разобрали случай до конца: переиграли боевые запросы и меняли по одному фактору за раз. Промпт оказался ни при чем. Модель слушалась собственной истории диалога, и ниже я покажу, как мы это нашли, какие получились цифры и что с этим делать, если вы строите на LLM чат‑бота, агента или ассистента.

Читать далее
  •  

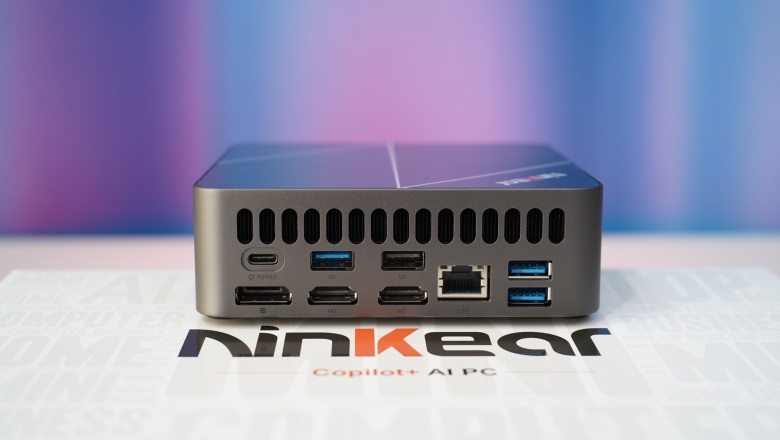
Настройка и пример работы LLM на встроенном NPU мини-компьютера с Intel Core Ultra 5 226V

Подопытный — мини-ПК Ninkear L20 на Intel Core Ultra 5 226V с 16 ГБ памяти. Ниже — установка и настройка OpenVINO, запуск Qwen3-8B на NPU, замеры скорости и мощности по счётчикам самого процессора и сравнение с дорогой видеокартой RTX 5070 Ti. Плюс практическая часть: обработка фотографий, 3D-рельеф из фото, озвучка книг, Blender и печатная плата. Всё работает локально, без утечек данных в интернет и без оплаты подписок.

Читать далее
  •  

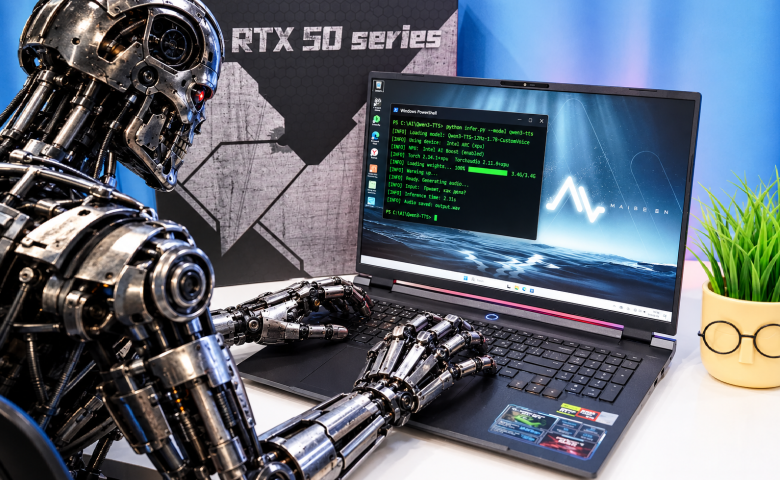
Локальный вайбкодинг на ноутбуке: Ryzen 9 и RTX5070 против Qwen3-Coder

Подписки на ИИ-ассистентов для кода дорожают, лимиты режут, а код при этом уезжает на чужие серверы. Я решил проверить, можно ли вайбкодить полностью локально на обычном игровом ноутбуке. Проверять буду на Meibenben X18A: Ryzen 9, RTX 5070 с 8 ГБ видеопамяти и 24 ГБ оперативной памяти на борту. Задача простая - запустить Qwen3 Coder, подключить к нему агента для программирования и посмотреть, что из этого выйдет.

Читать далее
  •  

Go в продакшене 2026: как язык вырос из микросервисов

Привет, Хабр! На связи Илья Данилкин, тимлид в Авито Авто. В этом материале я собрал подборку важных новостей из мира Go. Разберём, откуда берутся типичные утечки горутин и чем встроенный в рантайм детектор принципиально отличается от uber-go/goleak. Посмотрим, как устроен механизм GOEXPERIMENT и какие эксперименты стоит попробовать. Измерим, сколько реально даёт флаг GOAMD64 на современном железе. А также расскажу, почему языковые модели перестали быть просто предметом обсуждения и стали участниками самого процесса разработки — от поиска уязвимостей до профилирования сборщика мусора.

Читать далее
  •  

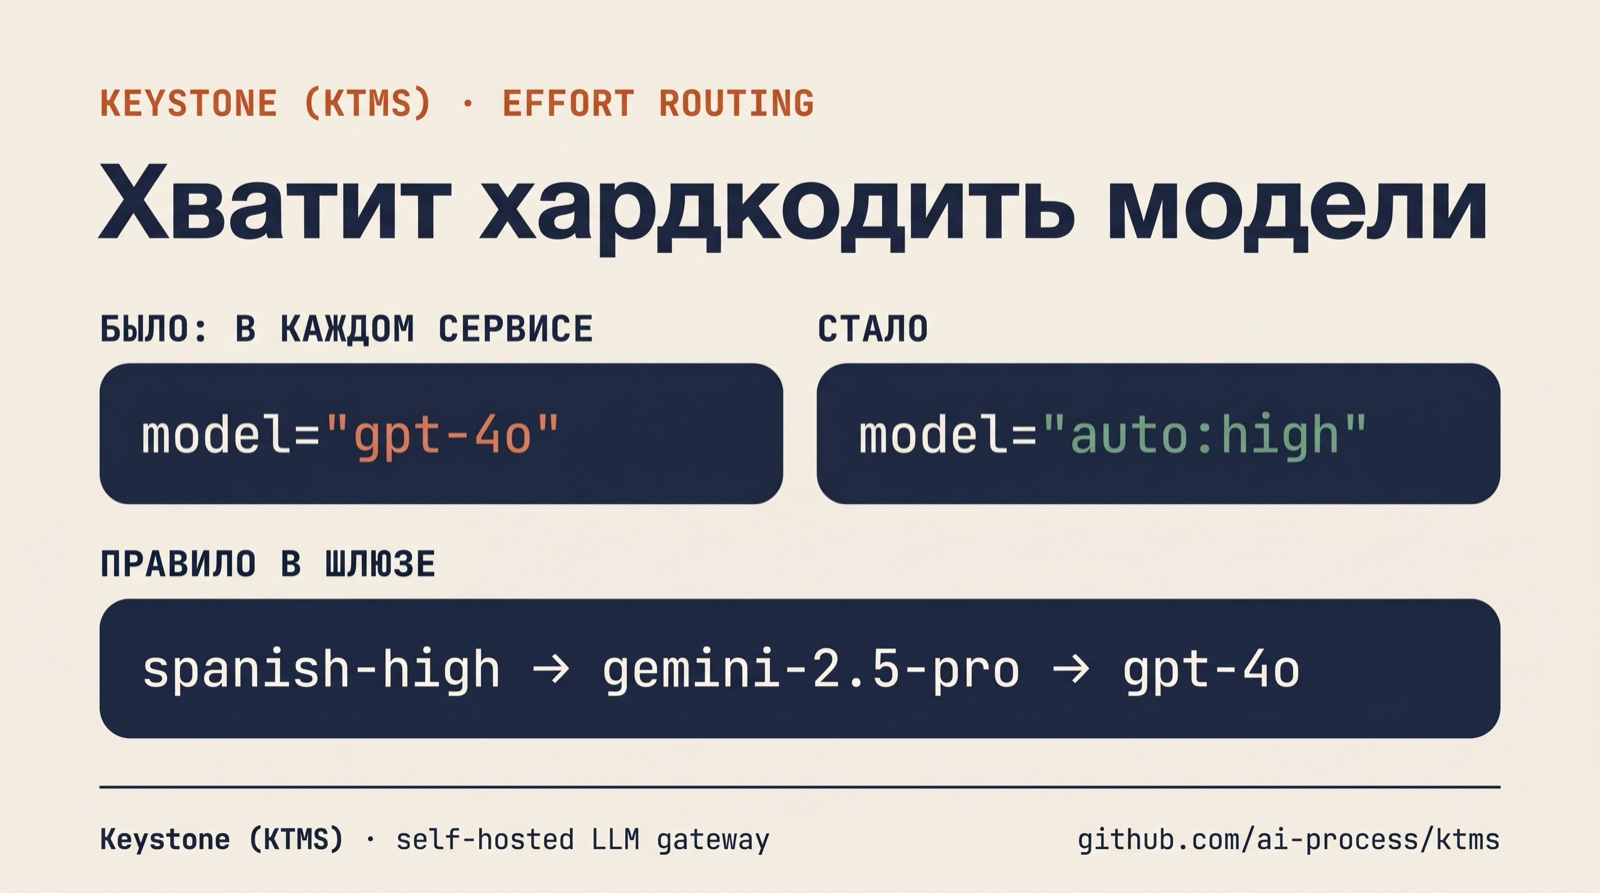
Как мы перестали хардкодить модели: effort-маршрутизация, авто-выбор сложности, фолбэки и лимиты расходов

Самая дорогая строчка в микросервисе с LLM — model="gpt-4o". За ней тянутся свой ключ вендора, свои ретраи и счёт, который потом некому разобрать.

Расскажу об одной идее, которая это убирает: сервис не должен знать, какая модель ему отвечает. Вокруг неё четыре механизма: правила маршрутизации, автоматический выбор сложности, поведение при сбоях вендоров и контроль денег. Примеры — из нашего open-source шлюза Keystone (KTMS) на Go, но схему можно повторить в любом шлюзе.

Читать далее
  •  

Как я подключил Hermes Agent к серверам, Obsidian, почте и разделил на Telegram-ботов

В статье рассказываю, как подключил Hermes Agent к своей инфраструктуре ServeHub-2 и использовал его для повседневных задач. Агент помогает работать с базой знаний Obsidian, проверять состояние серверов и следить за несколькими почтовыми ящиками.

Чтобы разделить задачи, я создал несколько профилей с отдельными Telegram-ботами. Так каждый агент отвечает за своё направление и использует собственные настройки.

Для работы с инфраструктурой я развернул Hermes на отдельном VPS и подключил его к защищенной сети. В статье разбираю эту схему и показываю настройку контейнера с клиентом, через который агент получает доступ к домашнему и удалённому серверам.

Также рассказываю, почему выбрал Hermes Agent, какие его возможности использую.

Читать далее
  •  

Я подсвечивал нейроны крохотного ИИ, чтобы понять, когда тот врет

В 2023 году адвокат из Нью-Йорка принес в суд записку со ссылками на прецеденты, которые ему «добросовестно» подобрал ChatGPT. Судья не нашел ни одного из этих дел. И не случайно: дел, на которые ссылался ИИ, не существовало вовсе. А через год Air Canada проиграла спор с пассажиром, которому чат-бот авиакомпании пообещал возврат денег по правилу, которое придумал ее же бот. Языковые модели ошибаются вполне уверенно, и по тексту ответа невозможно понять, путается ли модель искренне или привирает, прекрасно зная правильный ответ. Для людей эту задачу давно пытаются решать полиграфом, но он измеряет пульс и дыхание, то есть пытается замерить волнение, а с враньем оно связано очень косвенно.

Но у нейросети есть одно преимущество для исследователей: в отличие от человека, ее внутренности можно читать целиком. Буквально каждый нейрон. И все это без манжеты на руке и проводов на пальцах. Я решил проверить, получится ли собрать такой полиграф для языковой модели на домашней видеокарте. 

Первый же результат оказался интереснее, чем я рассчитывал изначально. Я попросил локальную модель соврать про цвет банана, и она уверенно ответила «Red», хотя на 25-м слое из 28 еще на 46% собиралась сказать «yellow». То есть правильный ответ у нее внутри был, а переписали его только последние слои. Но обо всем по порядку.

Читать далее

  •  

В релизе LiteLLM 1.107.0 обнаружены инфостилер и бэкдор

21 октября 2026 года LiteLLM 1.107.0 несколько часов работал как единый API не только к моделям, но и к секретам своего хозяина. В официальный релиз встроили инфостилер, отправляющий данные на сторонний домен, и бэкдор, позволяющий злоумышленникам выполнить произвольный код (RCE) в зараженном окружении. Подпись и статус официального релиза при этом были на месте.

Наш материал — короткий обзор для операторов и пользователей ИИ-шлюзов: что произошло, чем это грозит и какие действия нужно предпринять, если 1.107.0 запускалась.

Читать далее
  •  

AI-менеджер для WB, Ozon и Маркета: отдали решения агенту и сразу его ограничили

Первую версию AI-менеджера маркетплейсов мы собрали на регулярках: фраза → операция из закрытого списка → API площадки. Первые владельцы быстро показали, где это ломается: люди пишут не по списку, а цифры без выводов селлеру не нужны.

Мы переделали менеджера в агента: модель сама выбирает инструменты и порядок. И сразу же его ограничили: 8 шагов и 150 секунд на ход, узкие инструменты, запись в кабинет — только после «да» владельца. Рассказываем, как это устроено, с кодом, и что дали агенту вместо сценариев.

Читать далее
  •  

[Перевод] Фаззер против ИИ-агента на V8: 37 и 45 уязвимостей за полгода, общих — четверть

В Project Zero сравнили два конвейера, которые постоянно ищут уязвимости в V8, JavaScript-движке Chrome: фаззер Fuzzilli работает непрерывно, LLM-агент BigSleep раз в сутки просматривает новые коммиты. За апрель–сентябрь 2026 года после очистки от дубликатов и «нерабочих» репортов у BigSleep 45 исправленных уязвимостей, у Fuzzilli 37. Пересечение считали отдельно, с дополнительным поиском дубликатов через коммиты-исправления и базу Clusterfuzz: общими оказались 20 из 81 репорта, около четверти. В отдельном эксперименте агент на модели Gemini 3.6 flash получил коммиты, которые, вероятно, внесли 112 старых багов Fuzzilli, и за 25 попыток на каждый коммит заново нашёл около 62% из них. Баги, на которые фаззер тратил больше времени, агенту тоже давались хуже, а в JIT-компиляторах пересечение меньше. В переводе статьи Самуэля Гросса — методика подсчёта, проверка на запоминание обучающих данных и три разобранных бага: какие нашёл только агент и какой — только фаззер.

Читать далее
  •  

Миллион в config.toml, 828 тысяч в Codex и 890 тысяч на входе: что на самом деле значит окно контекста

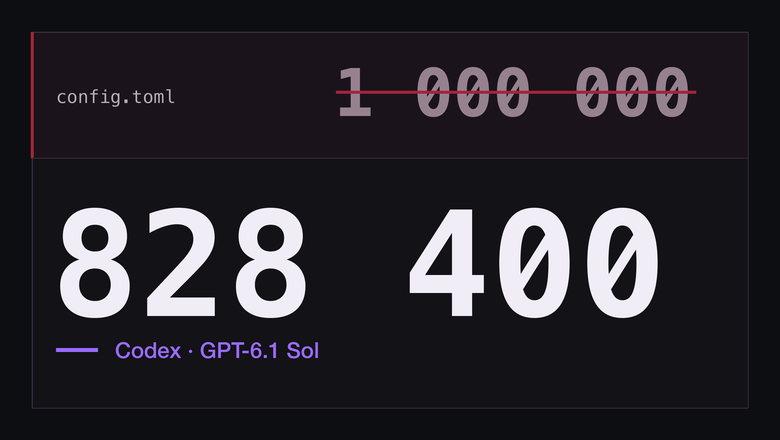
В ~/.codex/config.toml у меня стоит model_context_window = 1000000. Codex на GPT-6.1 Sol в каждой задаче сообщает окно 828 400.

Я разобрал, откуда берётся это число, поднял его до 900 000 своим каталогом моделей и прогнал синтетический вход на 890 547 токенов с контрольными метками.

Контрольный запуск показал больше основного: тот же вход на 888 330 токенов прошёл и без моей правки, при окне 828 400.

Замеры сделаны 27.10.2026 на Codex CLI 0.163.0, вход через подписку ChatGPT. Часть данных - из сентябрьских проб на GPT-6 Astra, это помечено.

Читать далее
  •  
❌