❌

Reading view

Ваш recover() эту ошибку не поймает

В Go‑сервисе recover() может выглядеть надёжной страховкой, пока конкурентная запись в map не завершает процесс через fatal error: concurrent map writes. При этом часть гонок проходит незаметно и приводит к потере данных без единой ошибки в логах. В статье разбираемся, почему recover() не спасает в таких ситуациях, как обнаружить проблему с помощью -race и какой способ синхронизации выбрать для общей map.
Разобрать проблему
  •  

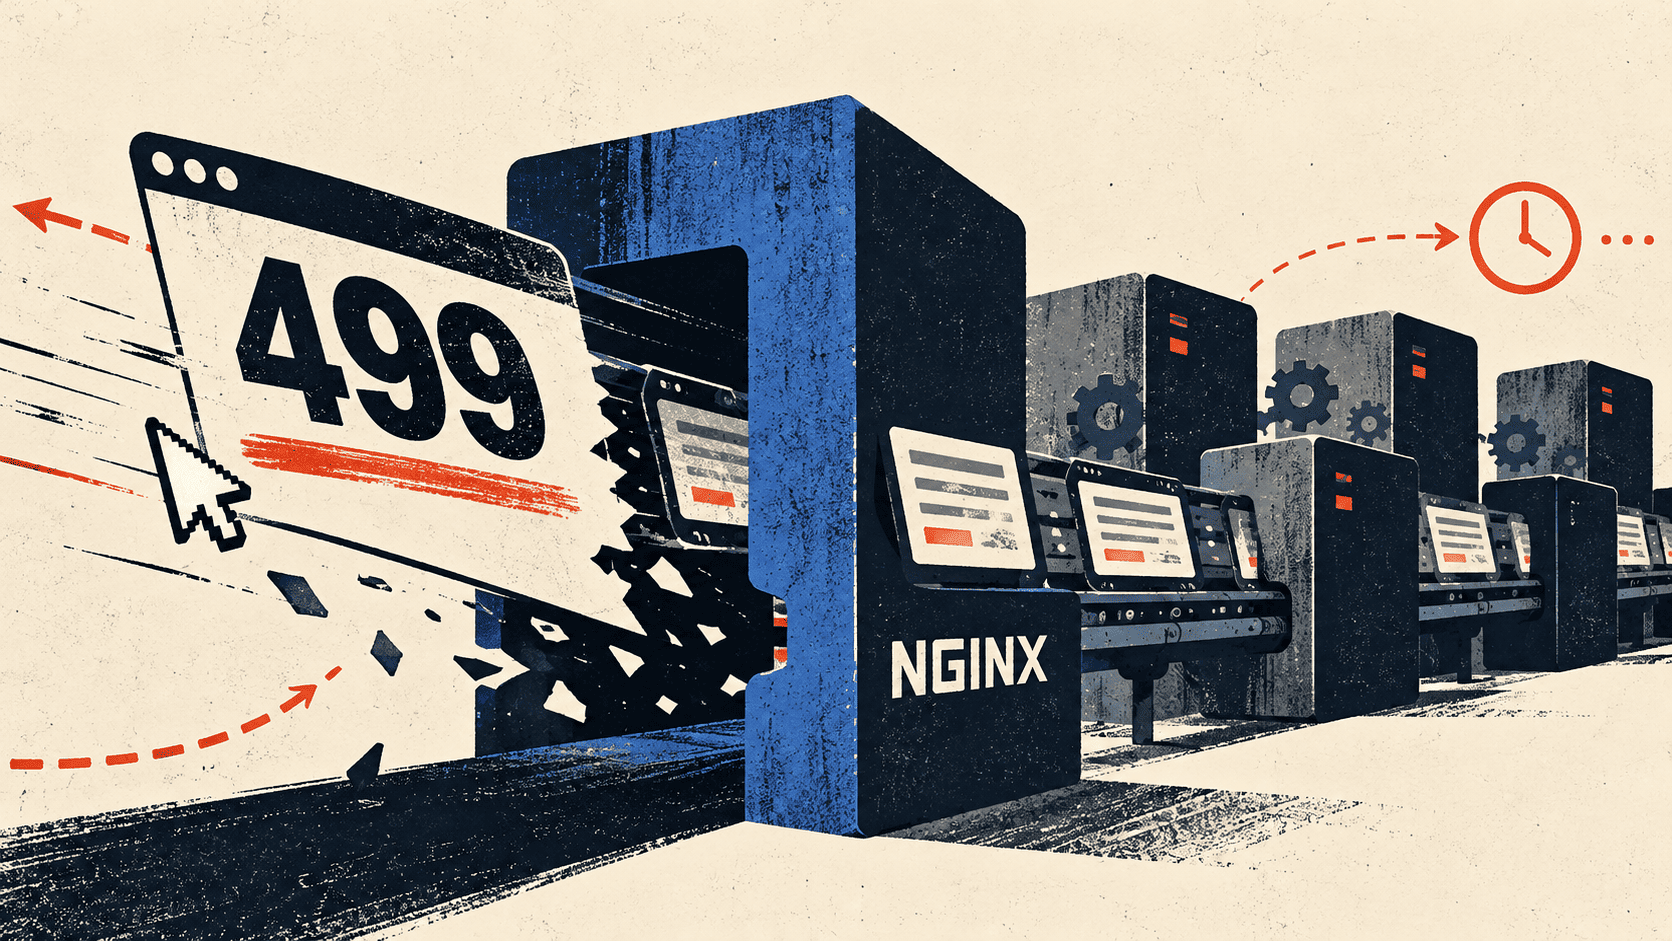
«client prematurely closed connection», хотя пользователь никуда не уходил

В логах nginx появляется 499, и кажется, что клиент просто закрыл соединение. Но за таким обрывом может скрываться таймаут балансировщика, медленный бэкенд и запросы, которые продолжают выполняться впустую. На примерах с Go, aiohttp и Angie разбираемся, откуда берутся 499, как они влияют на инфраструктуру и по каким признакам отличить обычную отмену запроса от проблемы на стороне сервера.

Разобраться с 499
  •  

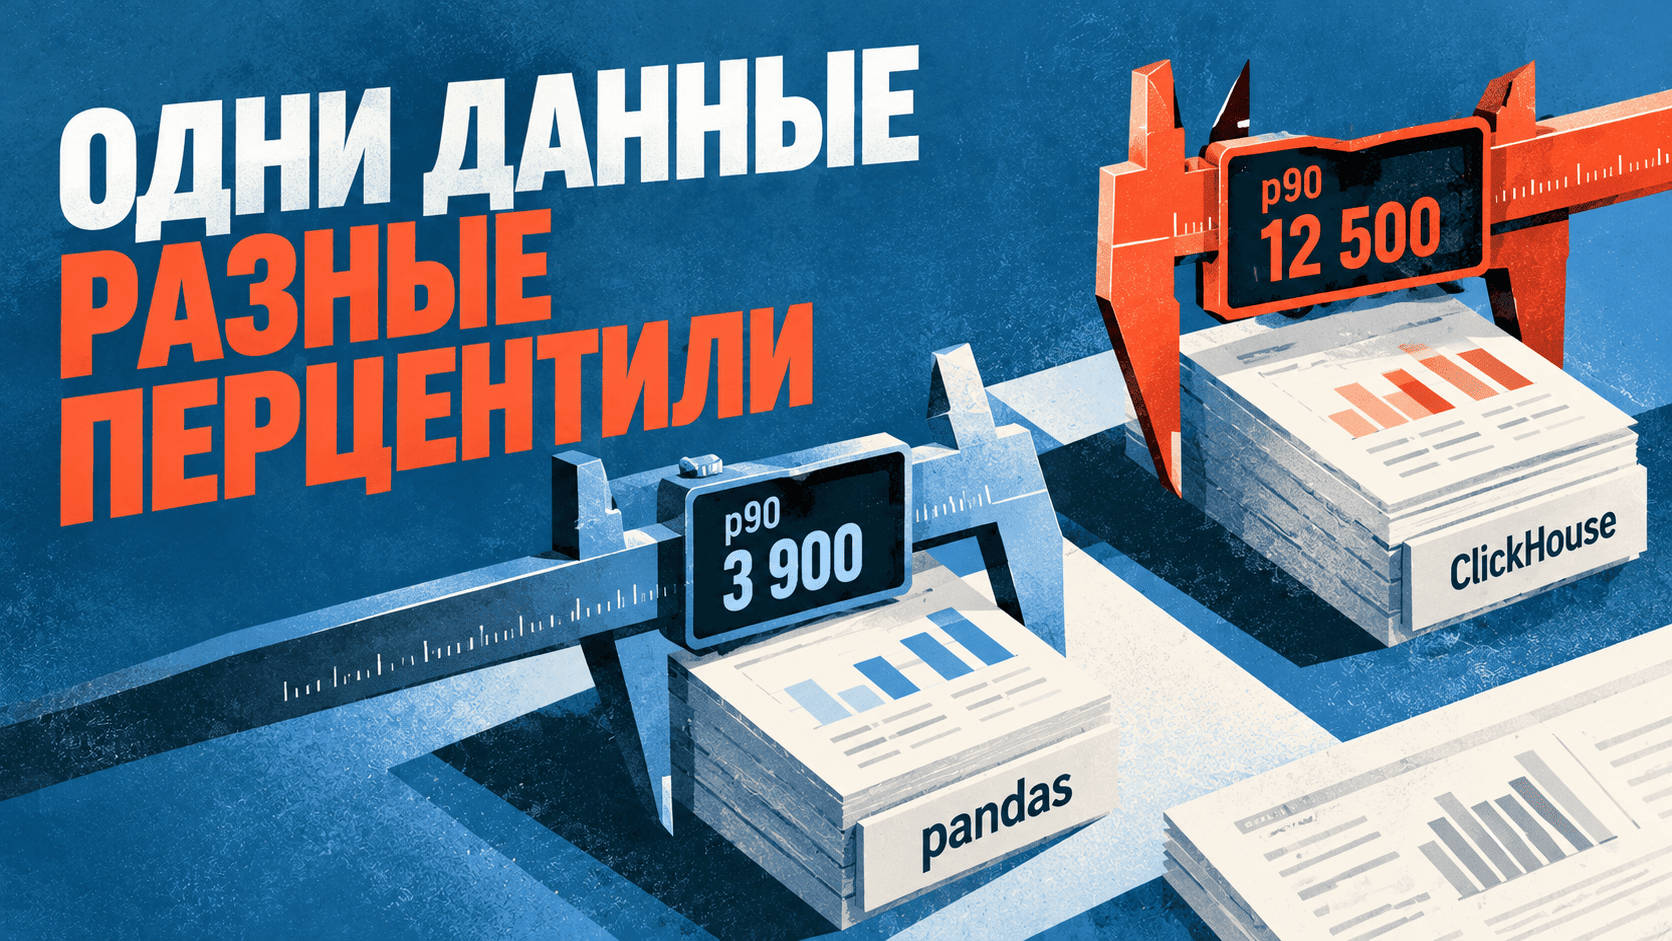
Почему pandas и ClickHouse считают разные перцентили на одних данных и как добиться совпадения

Один и тот же набор из десяти заказов, а p90 получается от 3900 до 12 500 рублей. В ноутбуке аналитика одна цифра, на дашборде другая, и даже повторный запуск запроса иногда меняет результат. Причина может скрываться в самой функции расчёта перцентиля — разберёмся, как разные инструменты выбирают значения и какой метод использовать, чтобы метрики можно было сравнивать.

Разобраться в перцентилях
  •  

Лог пустой, а диск заканчивается: что logrotate делает с файлами, которые приложение не закрывает

Диск заполняется, хотя logrotate исправно запускается, а свежий лог остаётся пустым. Причина может скрываться в открытых файловых дескрипторах, настройках ротации или поведении самого приложения. Разбираем на практических примерах, как logrotate взаимодействует с процессами, почему при ротации теряются записи и откуда берутся гигабайты невидимых логов.

Разобрать logrotate
  •  

Контейнер вышел за лимит памяти и не умер. Лучше бы умер

Контейнер упёрся в лимит памяти, но OOMKilled так и не появился. Сервис продолжает работать, задержки растут, CPU почти простаивает, а привычные метрики не объясняют, что происходит. На примере экспериментов с cgroup v2 разберём, как memory.high заставляет процессы ждать освобождения памяти и почему в Kubernetes это может обернуться минутами деградации производительности перед рестартом.

Разобрать эксперимент
  •  

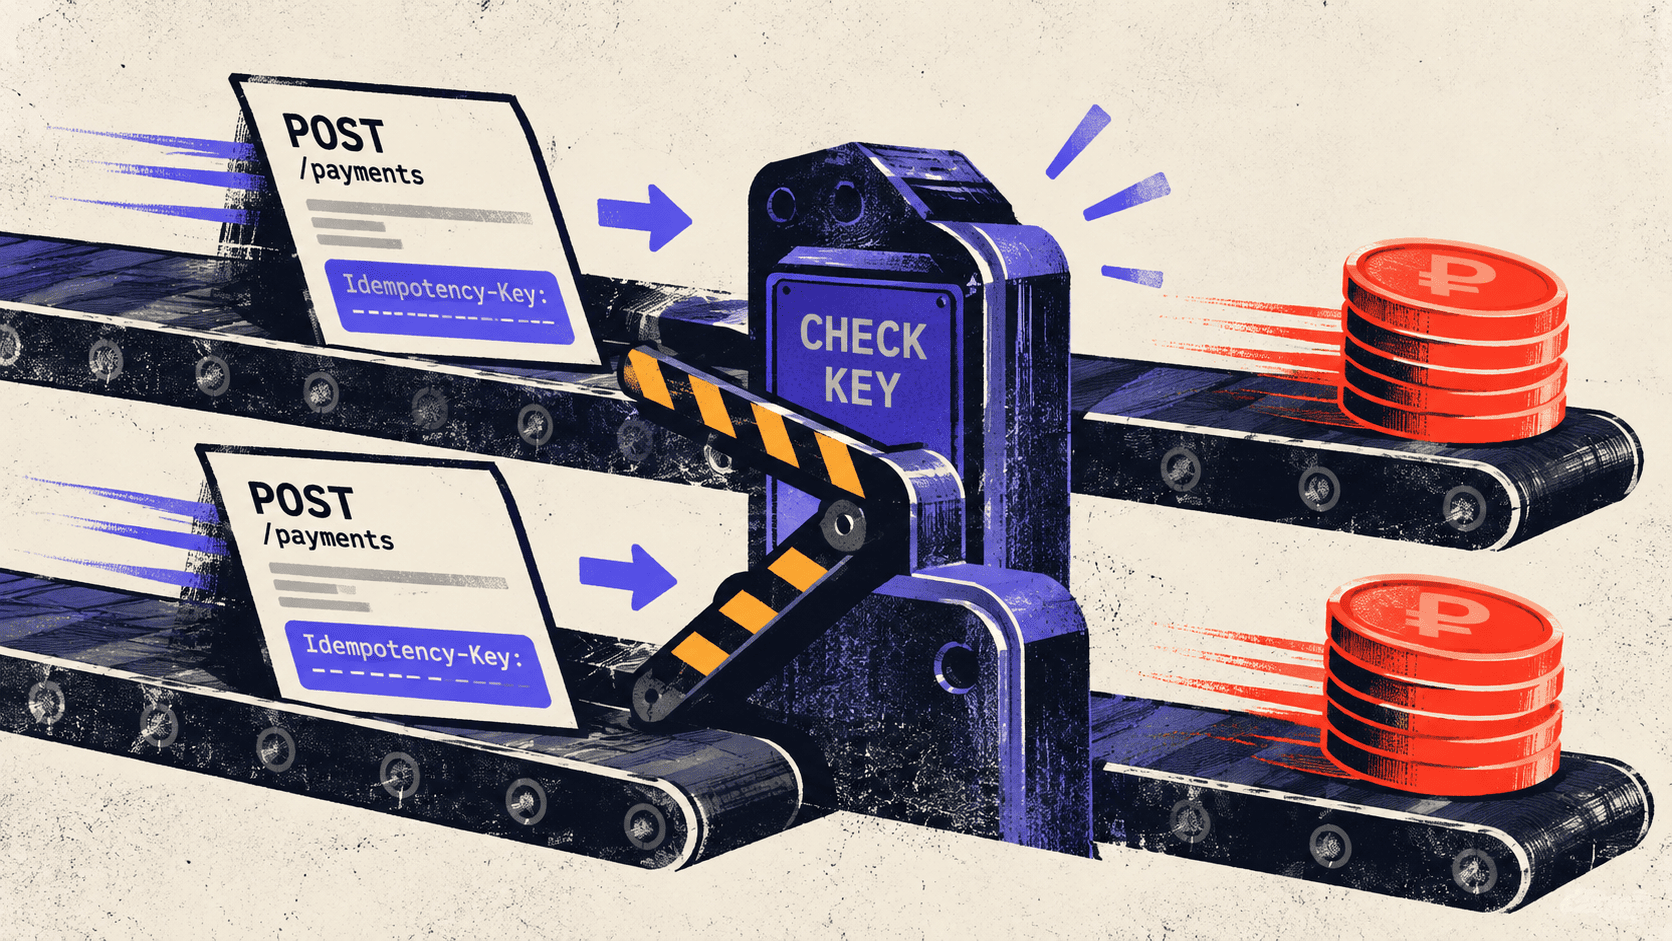
Почему Idempotency‑Key не спасает от двойного списания и как это исправить

Клиент отправил платёж, не дождался ответа и повторил запрос. На сервере предусмотрен Idempotency-Key, тесты проходят, но деньги всё равно списываются дважды. Проблема возникает, когда второй запрос приходит до завершения первого: оба обработчика успевают проверить ключ и запустить оплату.

Разберём, как закрыть эту гонку с помощью PostgreSQL, что делать при падении процесса и почему даже правильно реализованная идемпотентность внутри сервиса не всегда спасает от повторного списания.

Разобрать решение
  •  
❌