❌

Reading view

Staging-слой на EAV: случай, когда антипаттерн оправдан
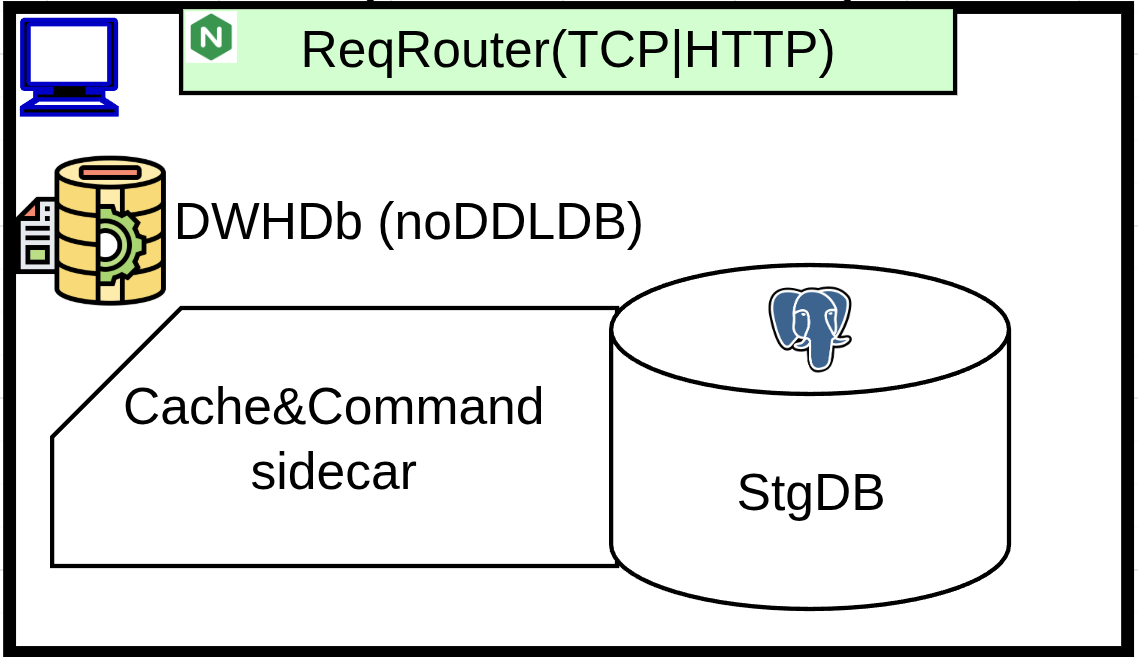
В этой статье — про STAGING-слой нашего DWH и о том, как мы работаем с EAV-паттерном. EAV в реляционной базе — устоявшийся антипаттерн, который в большинстве задач стоит обходить стороной. Рассказываю не о том, хорош EAV в целом или плох, а о конкретном случае, когда он оказался оправдан: почему он к нам пришёл, как мы с ним живём, что он даёт и где реально мешает.

Читать далее
  •  

Нужен ли Kubernetes сервису с одной базой данных? Четыре способа запуска и границы между ними

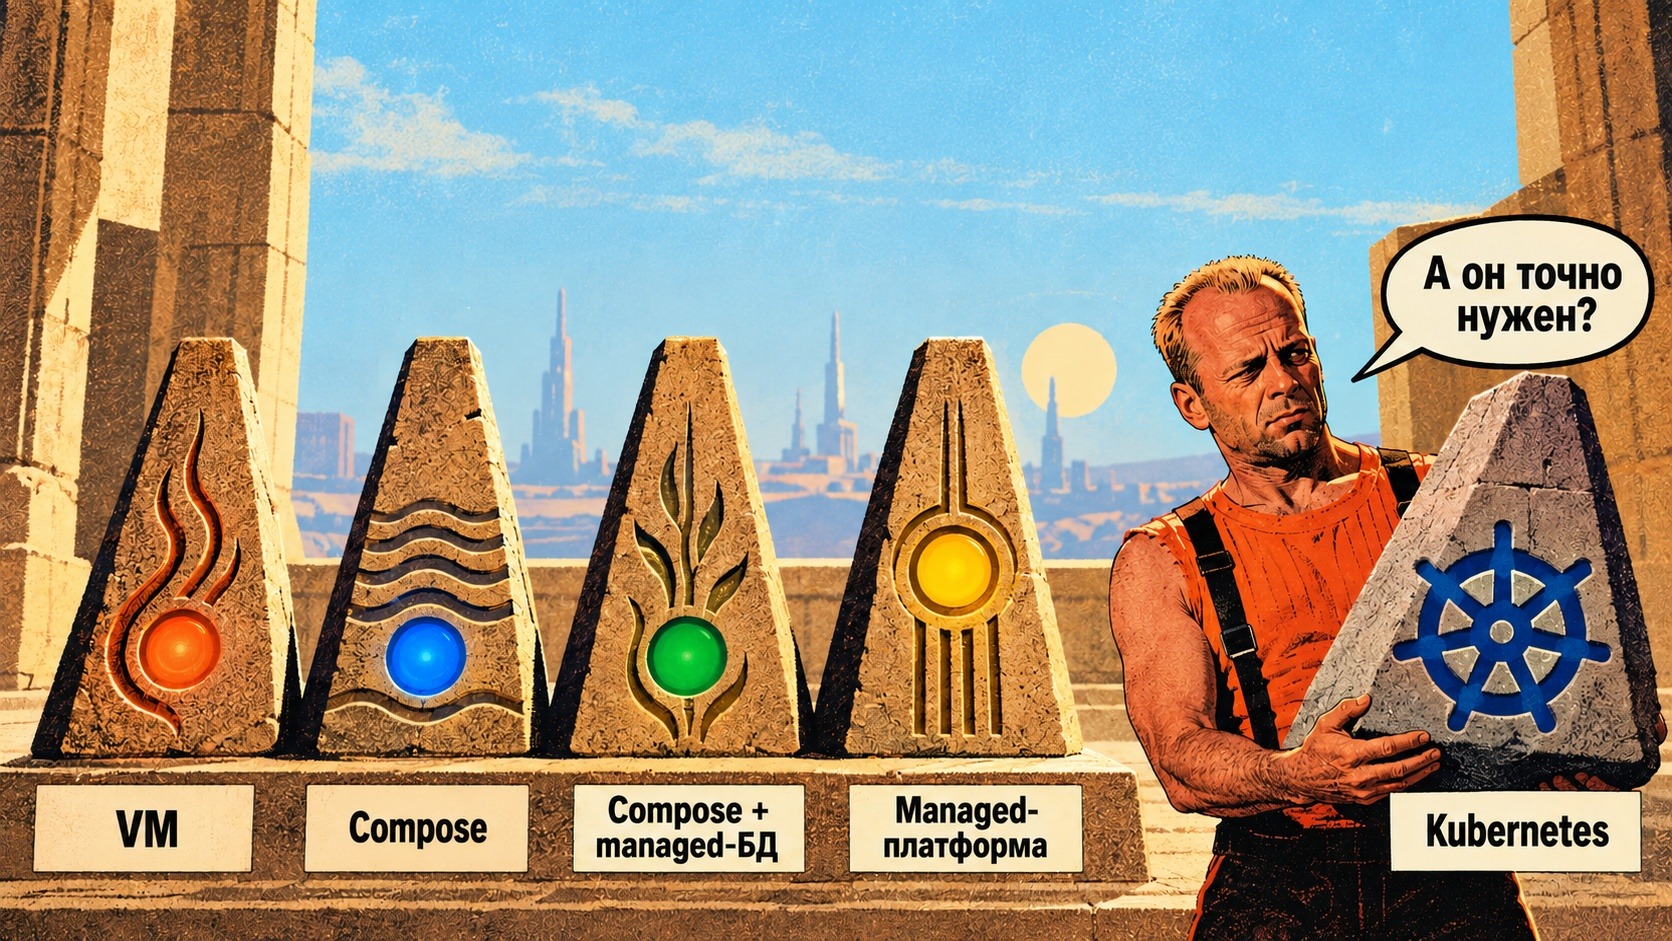
У вас небольшой сервис в облаке. Он работает, но проект растет: в команде больше разработчиков, появляются фоновые задачи, пользователи ждут стабильной работы. Пора менять инфраструктуру или текущая схема еще справится?

В статье решил сравнить четыре способа запустить одно и то же приложение и разобрал случаи, когда действительно нужен Kubernetes.

Эта статья для бэкенд-разработчиков, DevOps, SRE и тимлидов. Если вы работали с виртуалками и Docker, но пока присматриваетесь к Kubernetes — велком под кат.

Узнать, нужен ли пятый элемент
  •  

Все русскоязычные стримы в Postgres раз в 10 минут: 2 млн строк вместо 30 млн и баг, в котором я три недели винил VK

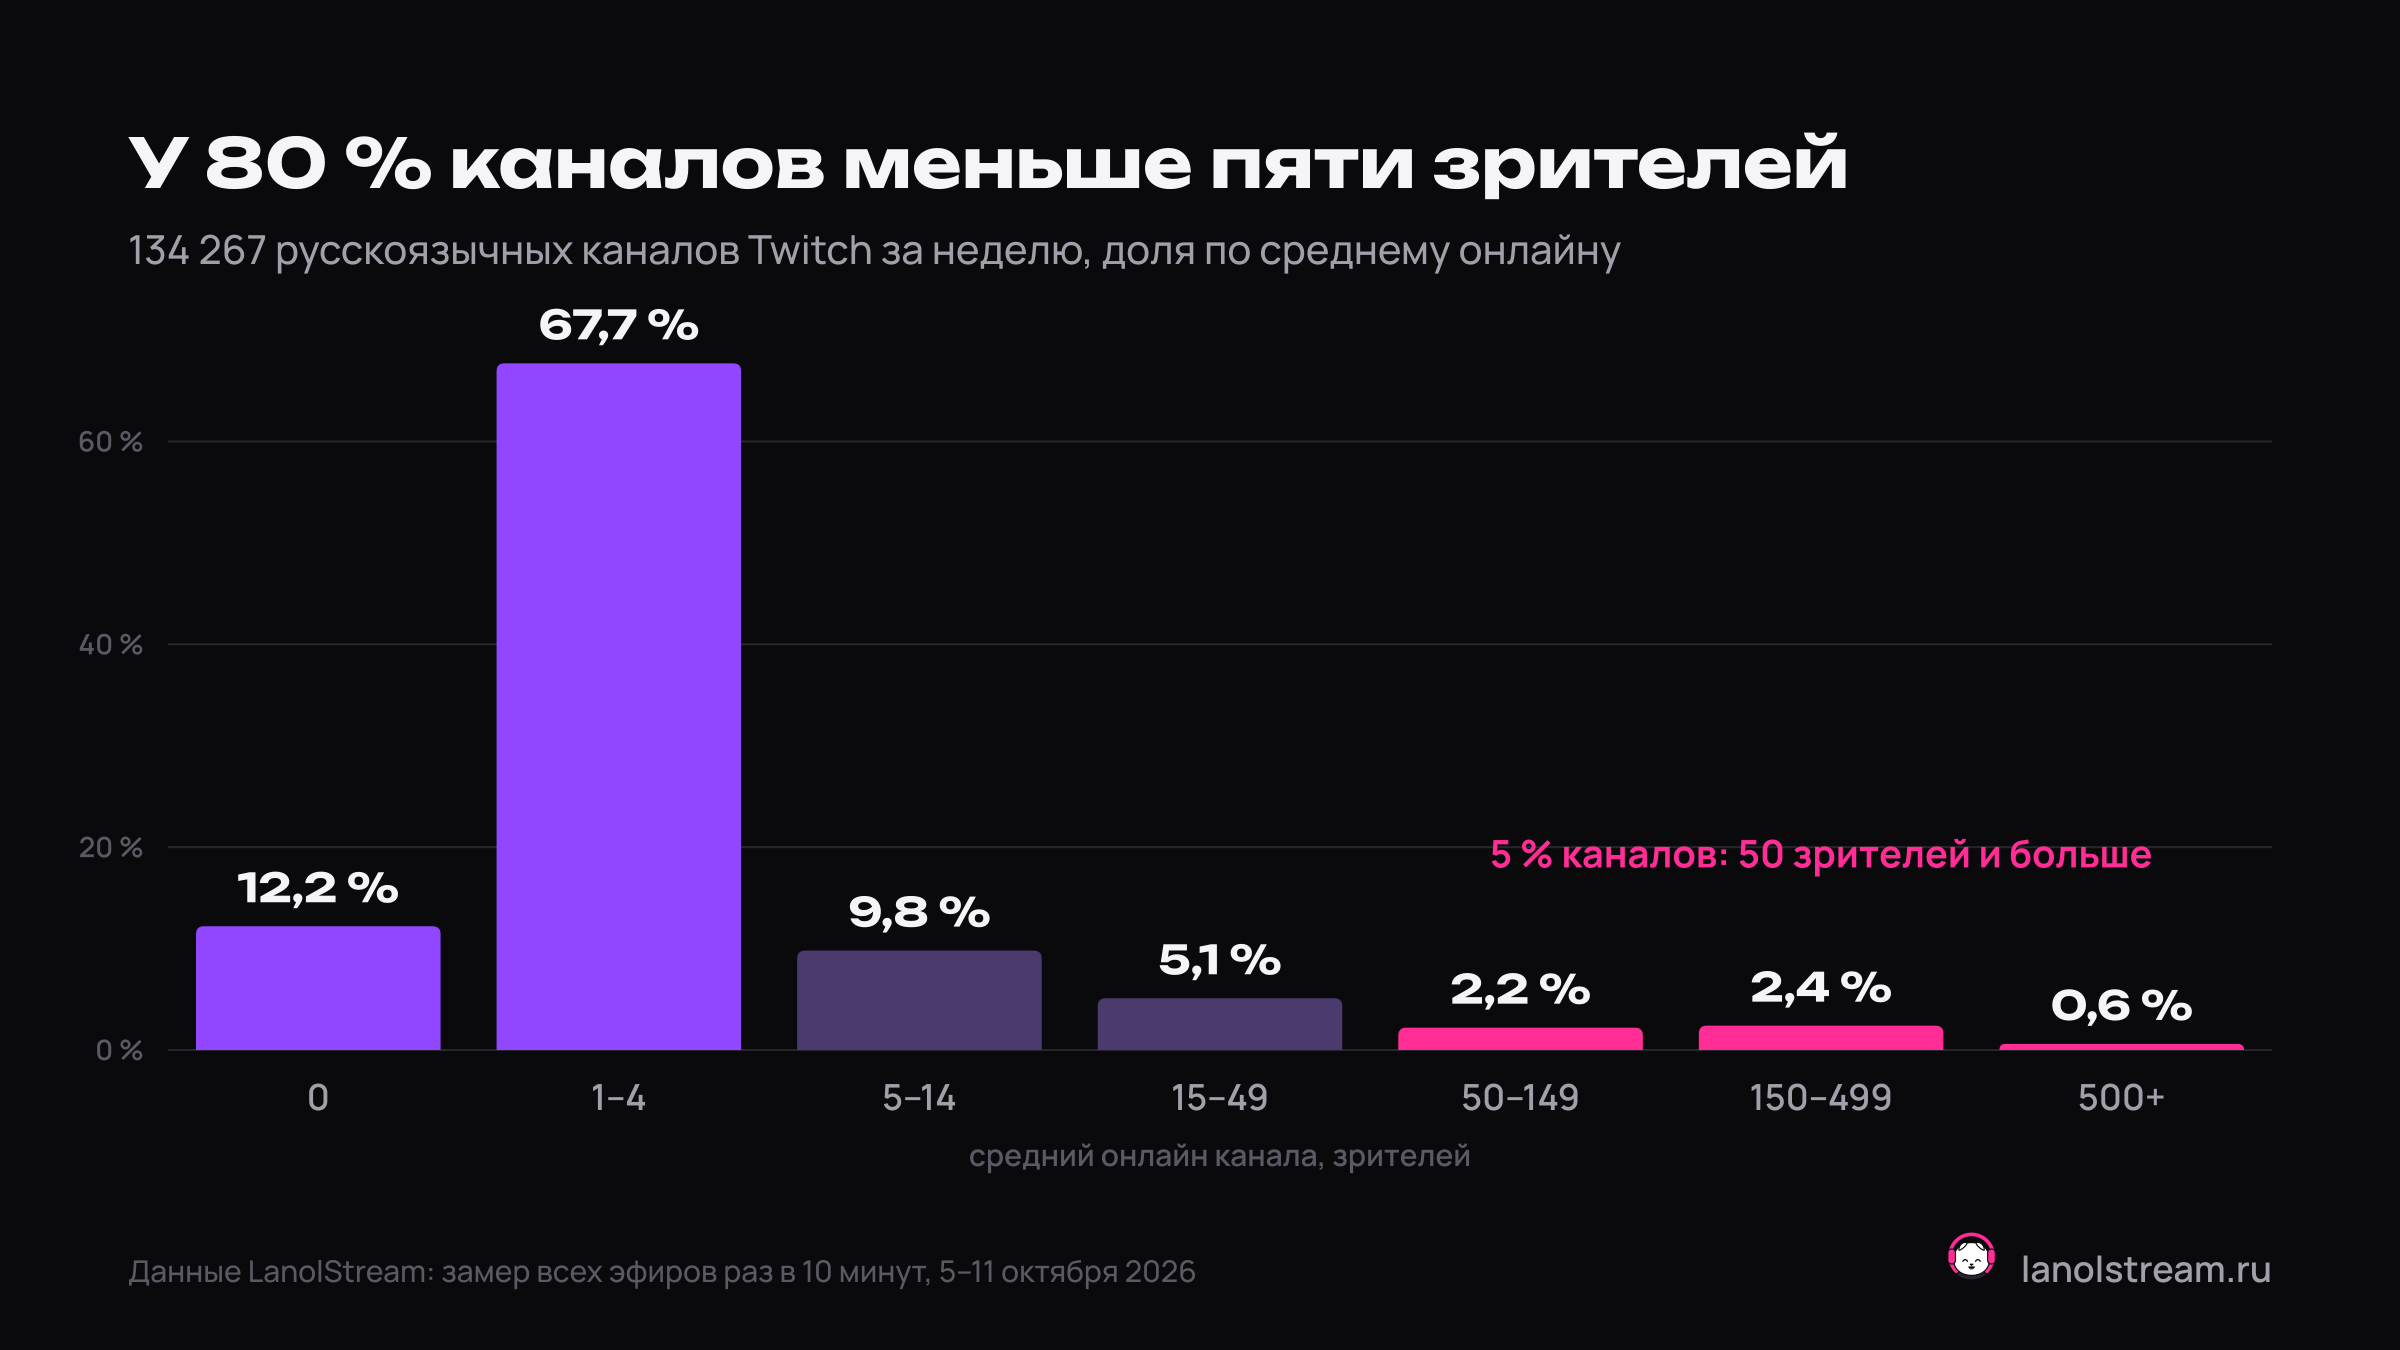
Каждые 10 минут в русскоязычном эфире Twitch и VK Видео Live в среднем 7 200 каналов. Писать их как есть - больше миллиона строк в сутки. Я храню агрегаты, и за четыре недели вышло 2 млн строк. Расскажу, как это устроено и где я три недели искал проблему не там.

Я Максим, разработчик, вечерами пишу LanolStream - инструменты для стримеров, которые мы делаем вместе со стримершей lanolkid. Стримеры часто спрашивают «во сколько лучше стримить» и «много ли у меня зрителей для моей игры». Чтобы отвечать цифрами, а не ощущениями, нужен весь рынок, а не только наши каналы.

Читать далее
  •  

Как построить self‑hosted RAG‑систему с LangGraph‑агентом на локальных LLM

Обычно стек для RAG‑систем и AI‑агентов строится вокруг облачных API (OpenAI, Anthropic) и управляемых векторных баз. Но для ряда задач критически важна полная автономность: устойчивость к санкциям и независимость от внешних провайдеров.

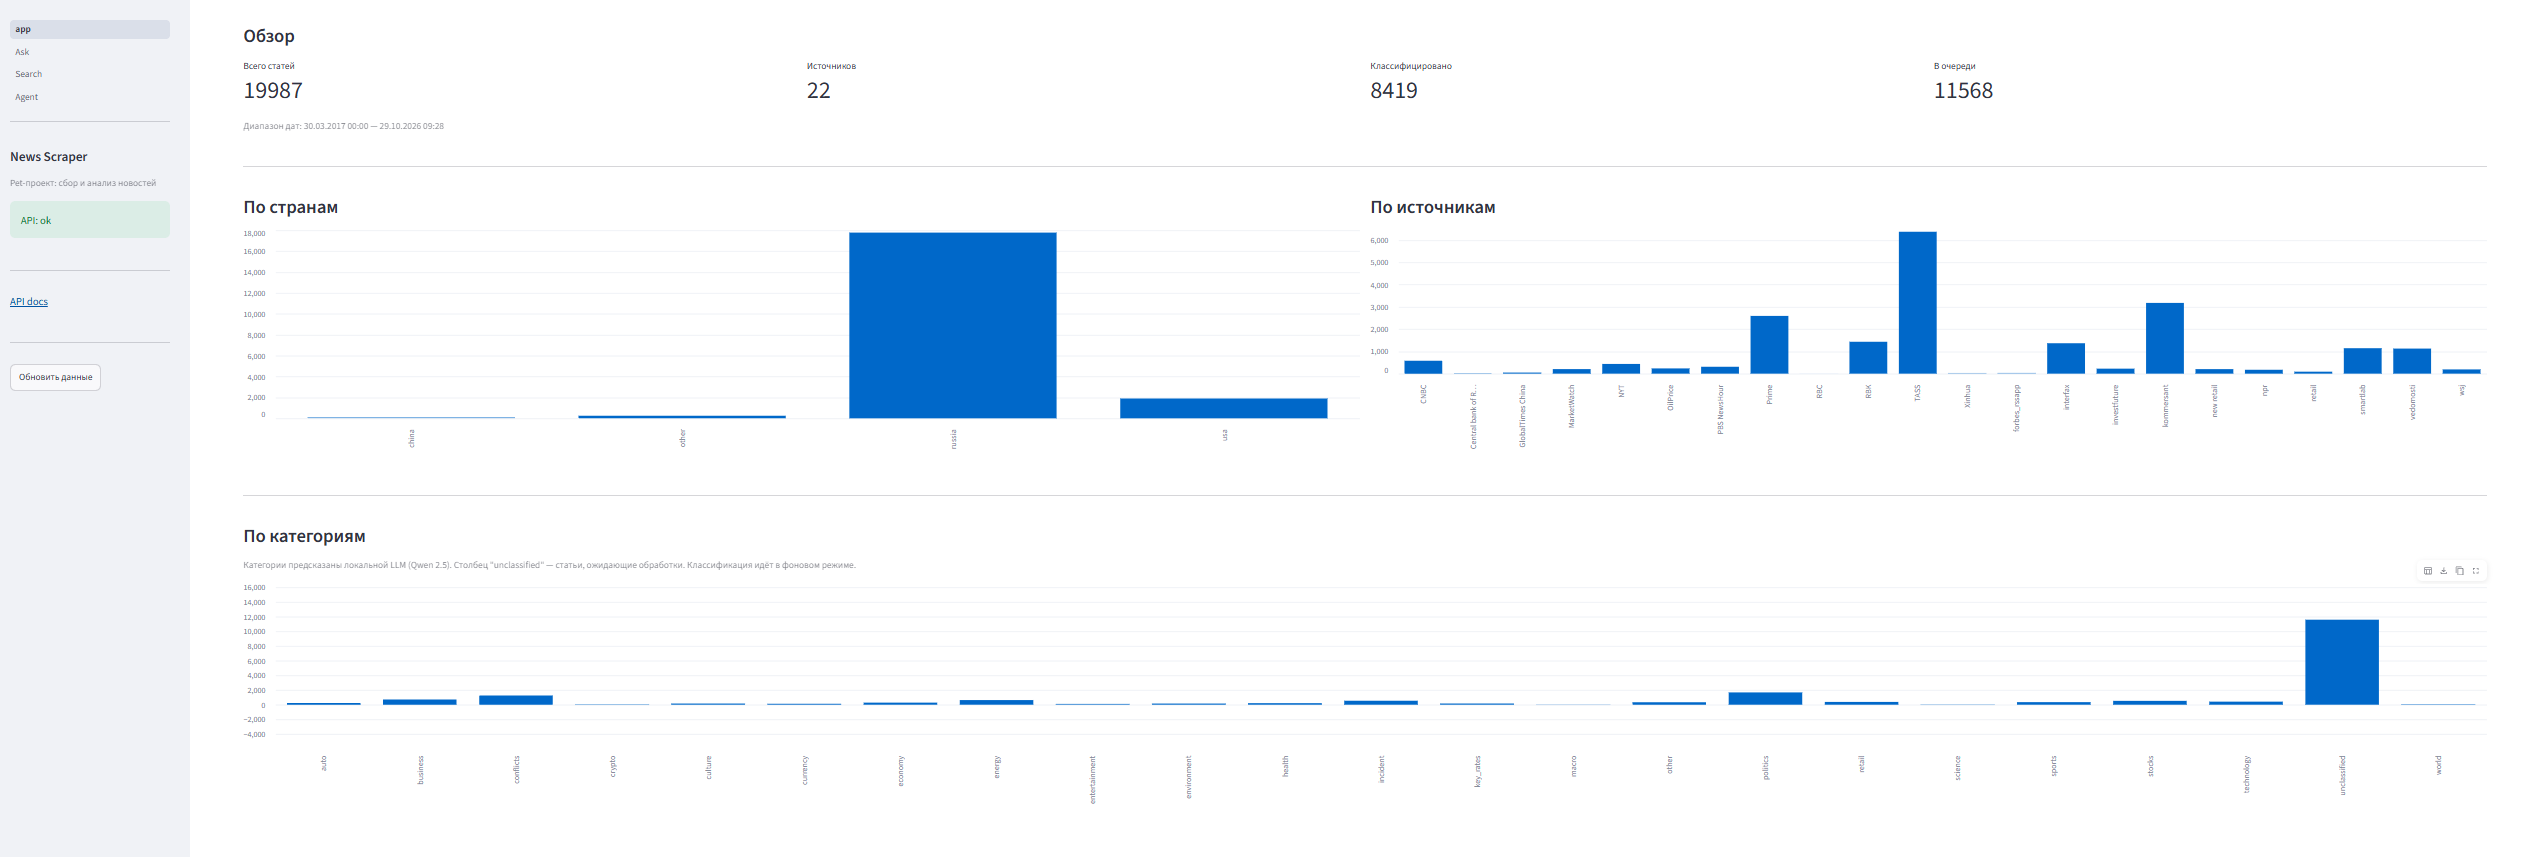
В этой статье я расскажу, как спроектировал и собрал аналитическую систему, которая за две недели работы агрегировала более 12 000 новостей: от сбора RSS‑лент до умного агента, который сам вызывает инструменты. Мы пройдем путь от архитектуры до граблей, на которые я наступил.

Стек: Python 3.12, FastAPI, PostgreSQL + pgvector, Celery, LangGraph, Ollama (Qwen 2.5 14B, BGE‑M3), Streamlit, Langfuse, Docker.

Читать далее
  •  

Что бэкапить в ИИ-приложении: модель, документы, индексы или историю диалогов?

Привет, Хабр! На связи Михаил Витко, менеджер PaaS-продуктов Рег.облака. Представим ситуацию. После восстановления ИИ-помощник принимает запросы и отвечает без ошибок. Но на вопрос о сроке возврата товара называет 14 дней вместо 30: база уже знает о новой редакции регламента, а поиск работает по старому индексу. Проверка доступности сервиса такую поломку не обнаружит.

В статье подробно разберем, как резервировать RAG-помощника по корпоративным документам и восстанавливать его части в согласованном состоянии. Тема обширная, поэтому мы разделили материал на две части. В первой поговорим о том, какие данные нужно сохранять, что можно пересоздать после сбоя и как организовать резервное копирование в S3, PostgreSQL и Kubernetes. А во второй обсудим, как восстановить приложение без рассогласования данных и проверить, что оно корректно работает после сбоя. 

Читать далее
  •  

Поддержка нескольких реляционных СУБД в одном проекте: PostgreSQL и MSSQL

Как поддерживать PostgreSQL и MSSQL в одном приложении, сохраняя единую кодовую базу?

На примере iLocks Online разбираем выбор провайдера в EF Core, отдельные наборы миграций, различия в последовательностях, типах данных и именовании объектов. Рассказываем, что необходимо проверять на обеих СУБД и почему подключения двух провайдеров недостаточно для полноценной совместимости.

Читать кейс
  •  

Книга «PostgreSQL 18. Оптимизация запросов»: основы работы планировщика в компактном формате

Запрос тормозит, а EXPLAIN ANALYZE выдаёт простыню узлов, в которой непонятно, на чём остановиться. Postgres Professional выпустила бесплатную книгу «PostgreSQL 18. Оптимизация запросов» на основе курса QPT. Она объясняет, как планировщик оценивает кардинальность и стоимость, как читать планы и какие приёмы работают для OLTP и OLAP. Читать можно хоть в метро: результаты запросов уже вплетены в текст, терминал не нужен.

Читать далее
  •  

Читать свои книги без подписок и DRM: как устроена Readora

У многих дома лежит папка с сотнями книг в FB2 — и почти ни одного удобного способа читать их где угодно. Десктопные читалки не синхронизируют прогресс, онлайн-сервисы требуют подписку и не принимают «свои» файлы, а связка Calibre с облаком — конструктор для энтузиаста. Рассказываем, как эту проблему решили браузером, PostgreSQL и открытым кодом — и почему в итоге всё свелось к скучному и предсказуемому стеку.

Но обо всём по порядку.

Погнали
  •  

PostgreSQL на 1 ТБ: сколько стоит облако и выделенный сервер

Облачные провайдеры удобны в использовании, но когда базы данных разрастаются до огромных размеров, становится страшно смотреть на выставленные счета. Один из способов сократить расходы — перенести базу на выделенный сервер. Кроме экономии, у выделенных серверов масса преимуществ: полный контроль над аппаратными ресурсами, отсутствие соседей по гипервизору, предсказуемая производительность. Именно поэтому компании успешно переводят свои тяжёлые проекты на выделенные серверы.

Возьмём PostgreSQL-базу объёмом 1 ТБ и сравним, во сколько обойдётся её размещение в AWS и на выделенном сервере. Заодно рассмотрим варианты переноса данных и расходы, которые стоит учесть помимо аренды.

Читать далее
  •  

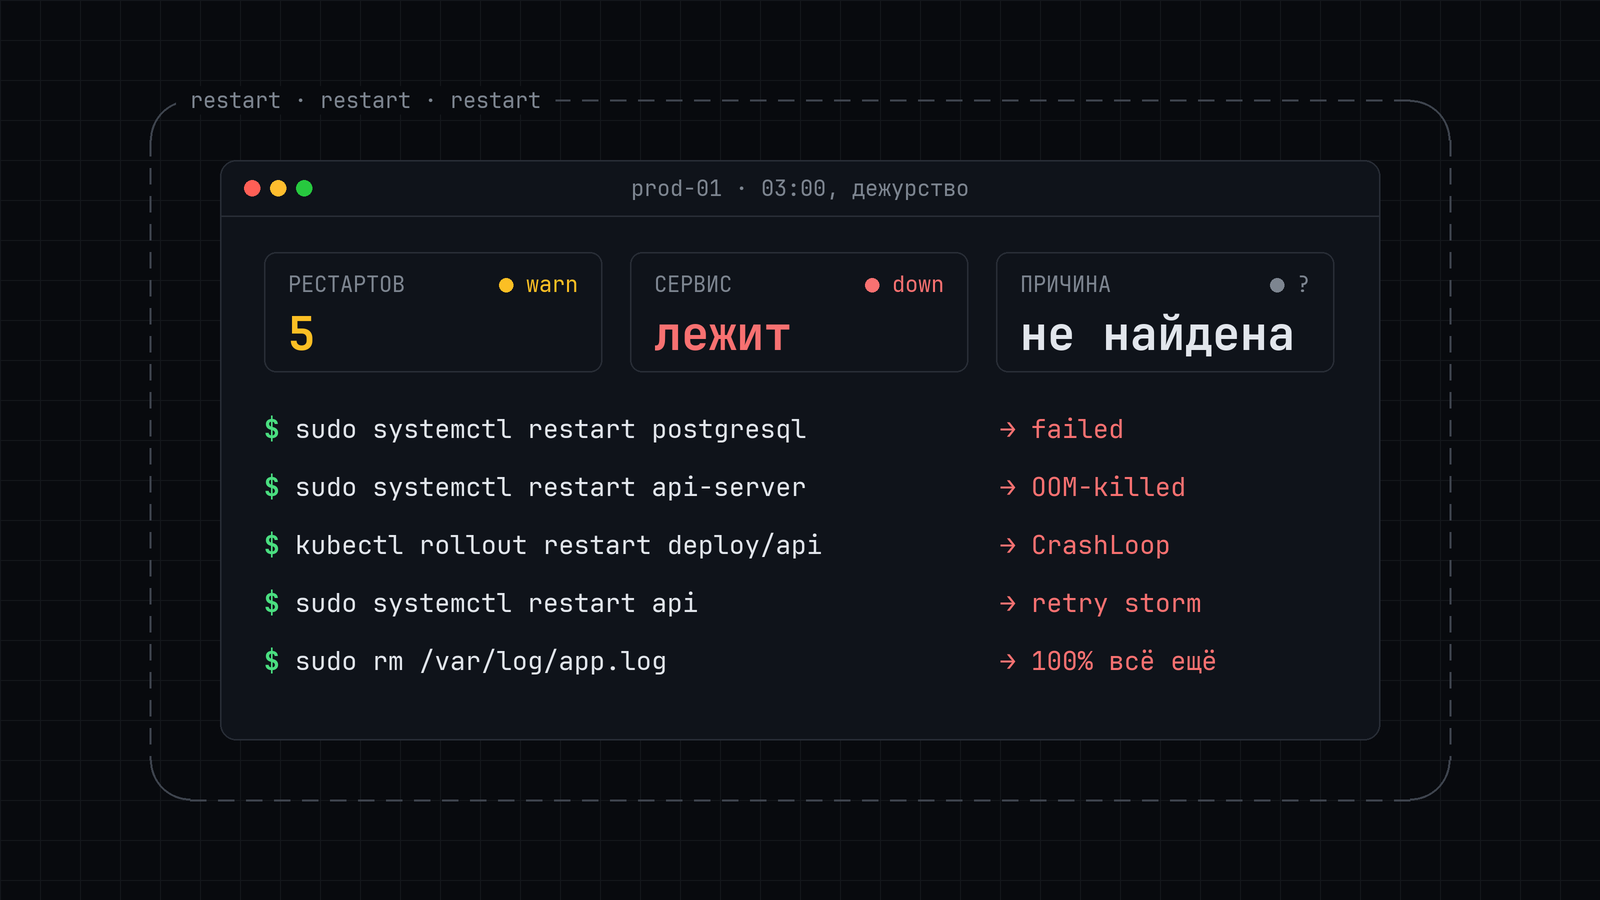
Перезапустил — и стало хуже: 5 инцидентов, которые не лечатся рестартом

Три часа ночи, API отвечает 500, и рука сама набирает systemctl restart. Иногда это помогает, но есть инциденты, где рестарт добивает то, что ещё работало, и стирает улики. Пять таких: битый конфиг, OOM killer, retry storm, CrashLoopBackOff и диск, забитый логом, — с командами, которые находят настоящую причину, и шпаргалкой на одну таблицу.

Читать далее
  •  

Эй, девелопер, дизайн твоего кода никуда не годится

Вы когда-нибудь читали такое сообщение от кодинг-агента? Мне не приходилось, а жаль.

Каждый раз, когда я довожу код, сгенерированный AI по моему ТЗ, я прогоняю его через ревью несколькими агентами с разными ролями и точками зрения — что-то вроде взгляда нескольких людей с разным опытом. И почти всегда получаю пачку разнокалиберных замечаний, от мелких до критических. Казалось бы, что сложного: открой новую сессию, скорми ей замечания, дай исправить, прогони ревью снова.

У этой замечательной стратегии, однако, есть одно слабое место: а мы уверены, что такой процесс сходится?

Читать далее
  •  

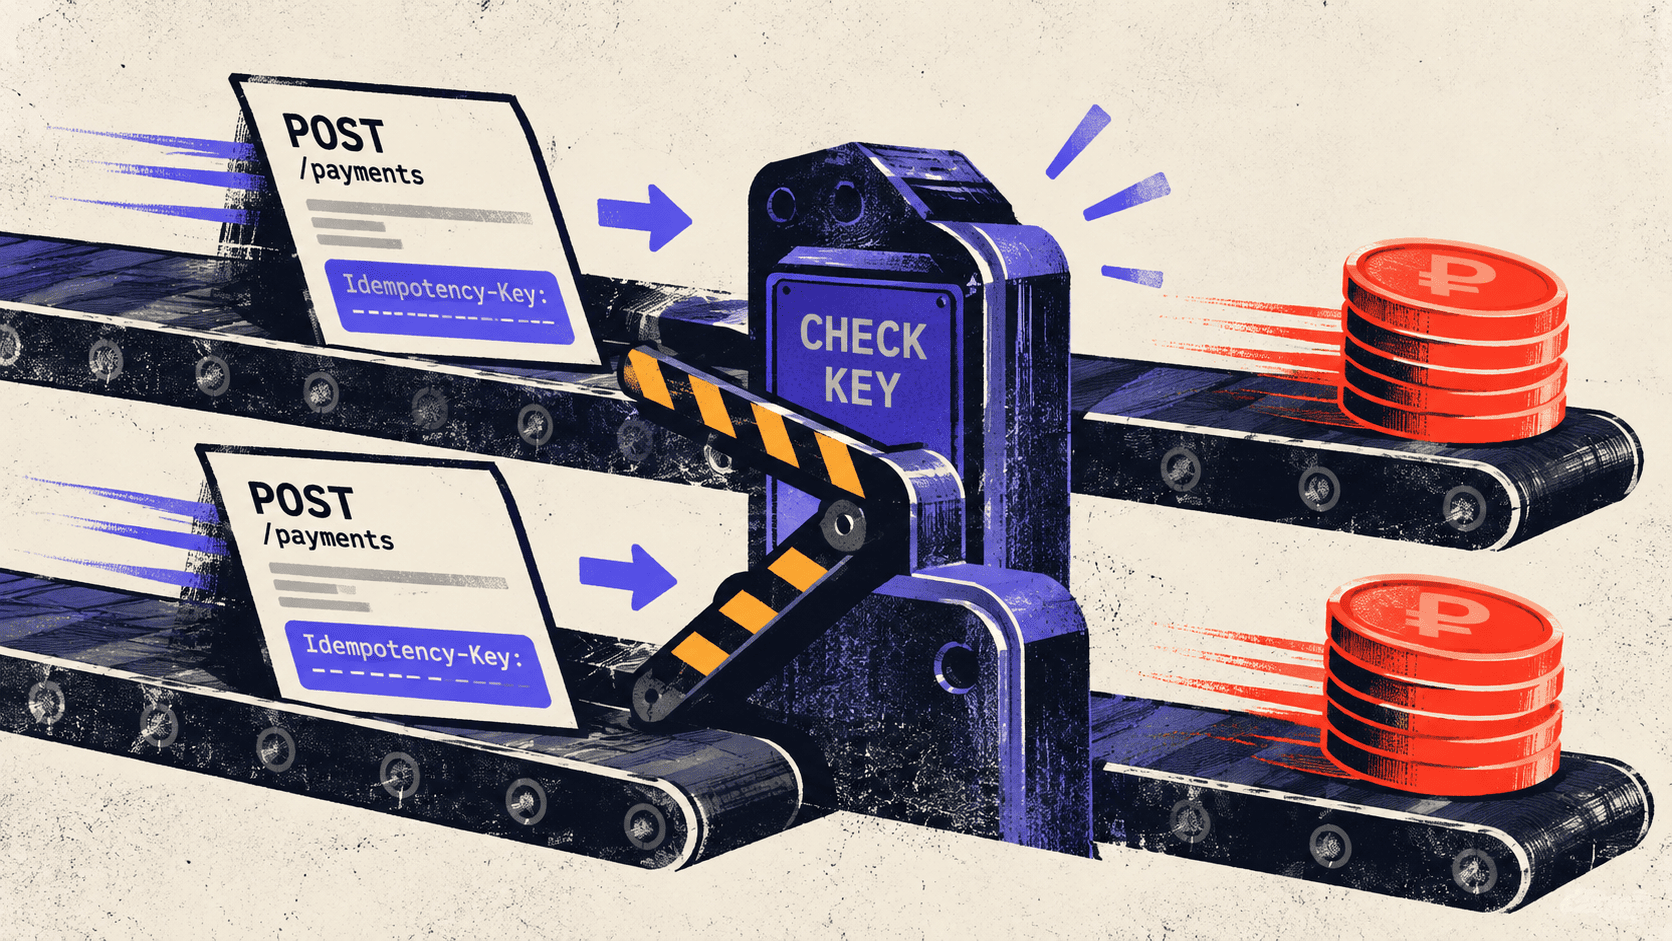
Почему Idempotency‑Key не спасает от двойного списания и как это исправить

Клиент отправил платёж, не дождался ответа и повторил запрос. На сервере предусмотрен Idempotency-Key, тесты проходят, но деньги всё равно списываются дважды. Проблема возникает, когда второй запрос приходит до завершения первого: оба обработчика успевают проверить ключ и запустить оплату.

Разберём, как закрыть эту гонку с помощью PostgreSQL, что делать при падении процесса и почему даже правильно реализованная идемпотентность внутри сервиса не всегда спасает от повторного списания.

Разобрать решение
  •  
❌