
❌

Reading view

О вузовских ИИ‑детекторах: что они могут, а чего нет. Неочевидные результаты собственного тестирования
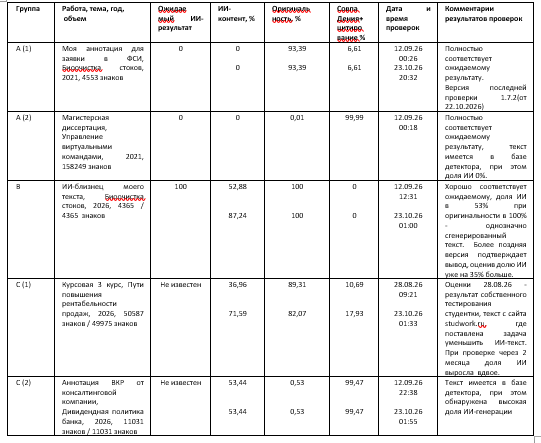
Написала аналитику по результатам тестирования трех вузовских ИИ-детекторов на академических текстах с известным происхождением. Один и тот же текст оценивается разными системами детектирования от нуля до шестидесяти процентов ИИ, а показания одной системы меняются на треть за полтора месяца. Предлагаю обсудить более эффективный способ определения авторства, чем тот, что применяется сейчас.

Читать далее
  •  

Почему LLM игнорирует системный промпт: история диалога сильнее инструкций

Знакомая ситуация: в системном промпте четко написано, что модель делать не должна ни в коем случае, а она все равно это делает. Вы переписываете правило, добавляете «ВАЖНО», капслок и примеры, становится чуть лучше, а потом снова за старое. В какой‑то момент начинаешь подозревать модель, ее настройки (например, температуру) или провайдера.

Мы наступили на это в голосовом ассистенте и разобрали случай до конца: переиграли боевые запросы и меняли по одному фактору за раз. Промпт оказался ни при чем. Модель слушалась собственной истории диалога, и ниже я покажу, как мы это нашли, какие получились цифры и что с этим делать, если вы строите на LLM чат‑бота, агента или ассистента.

Читать далее
  •  
❌